OCR COMPTA : Extraction de données de facturation
MBH OCR is an intelligent document processing solution that automatically extracts accounting data from scanned documents, invoices, and workbooks, streamlining financial workflows and improving accuracy.
Présentation du projet
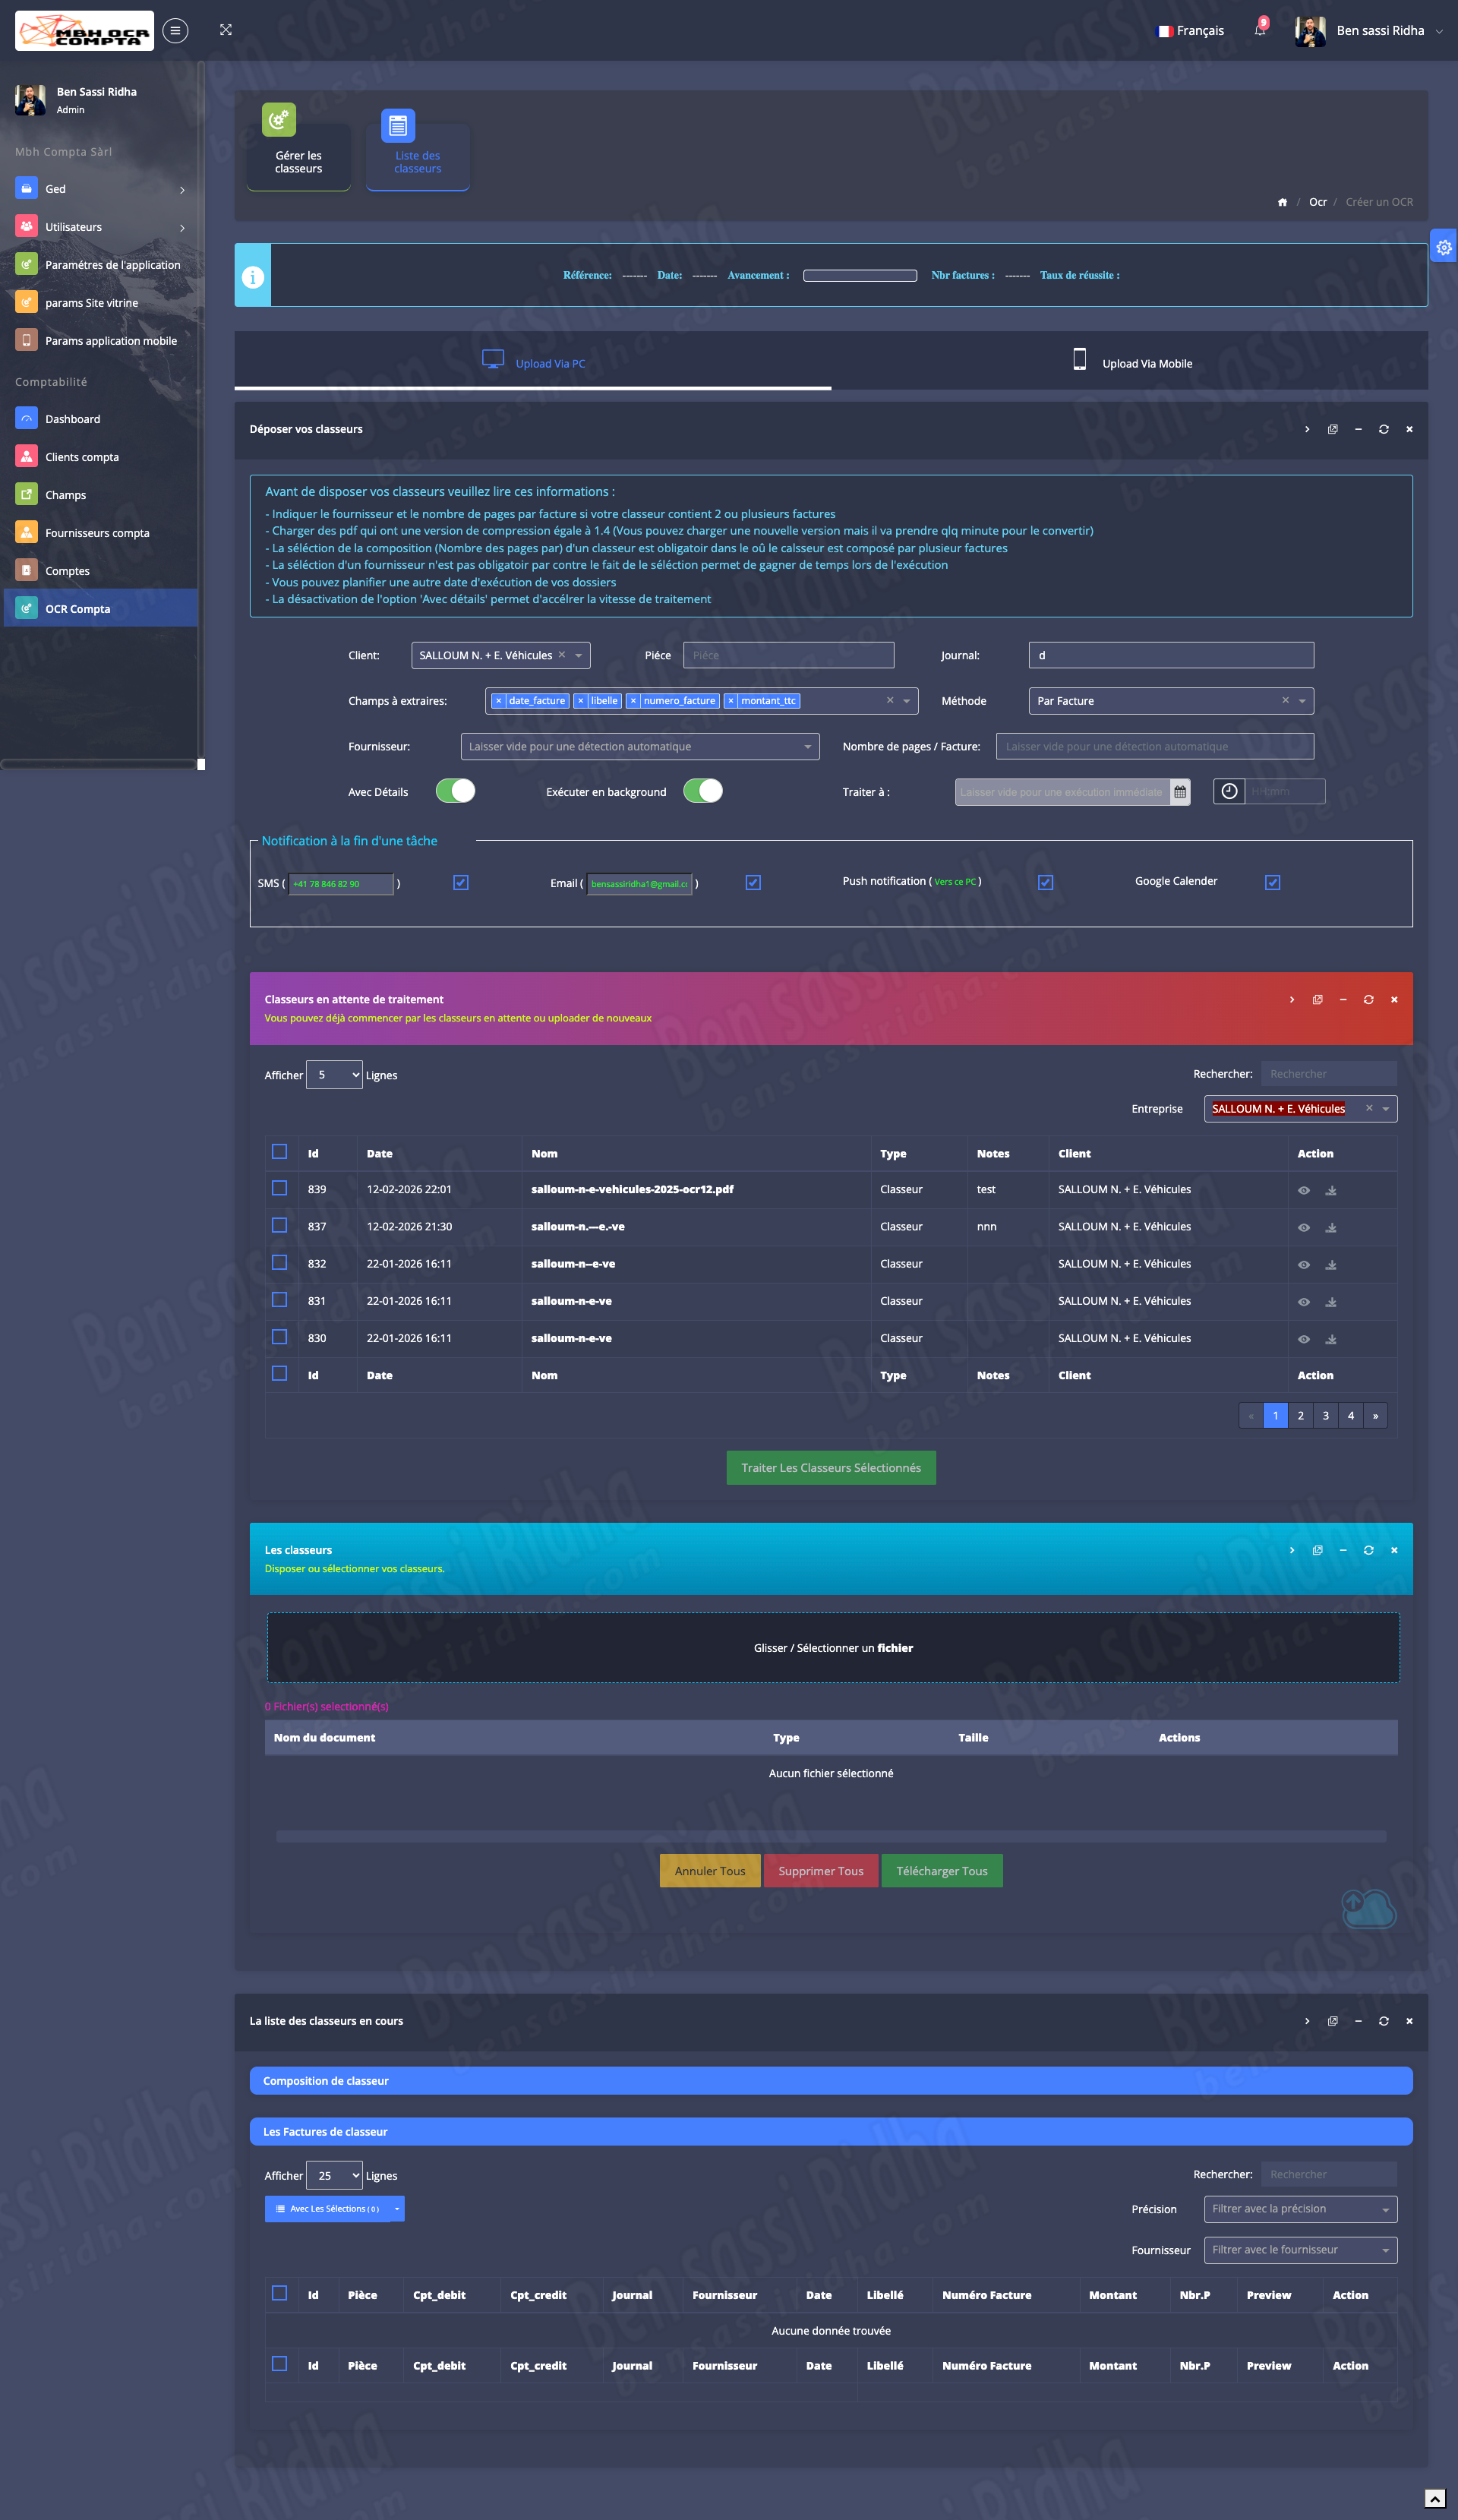
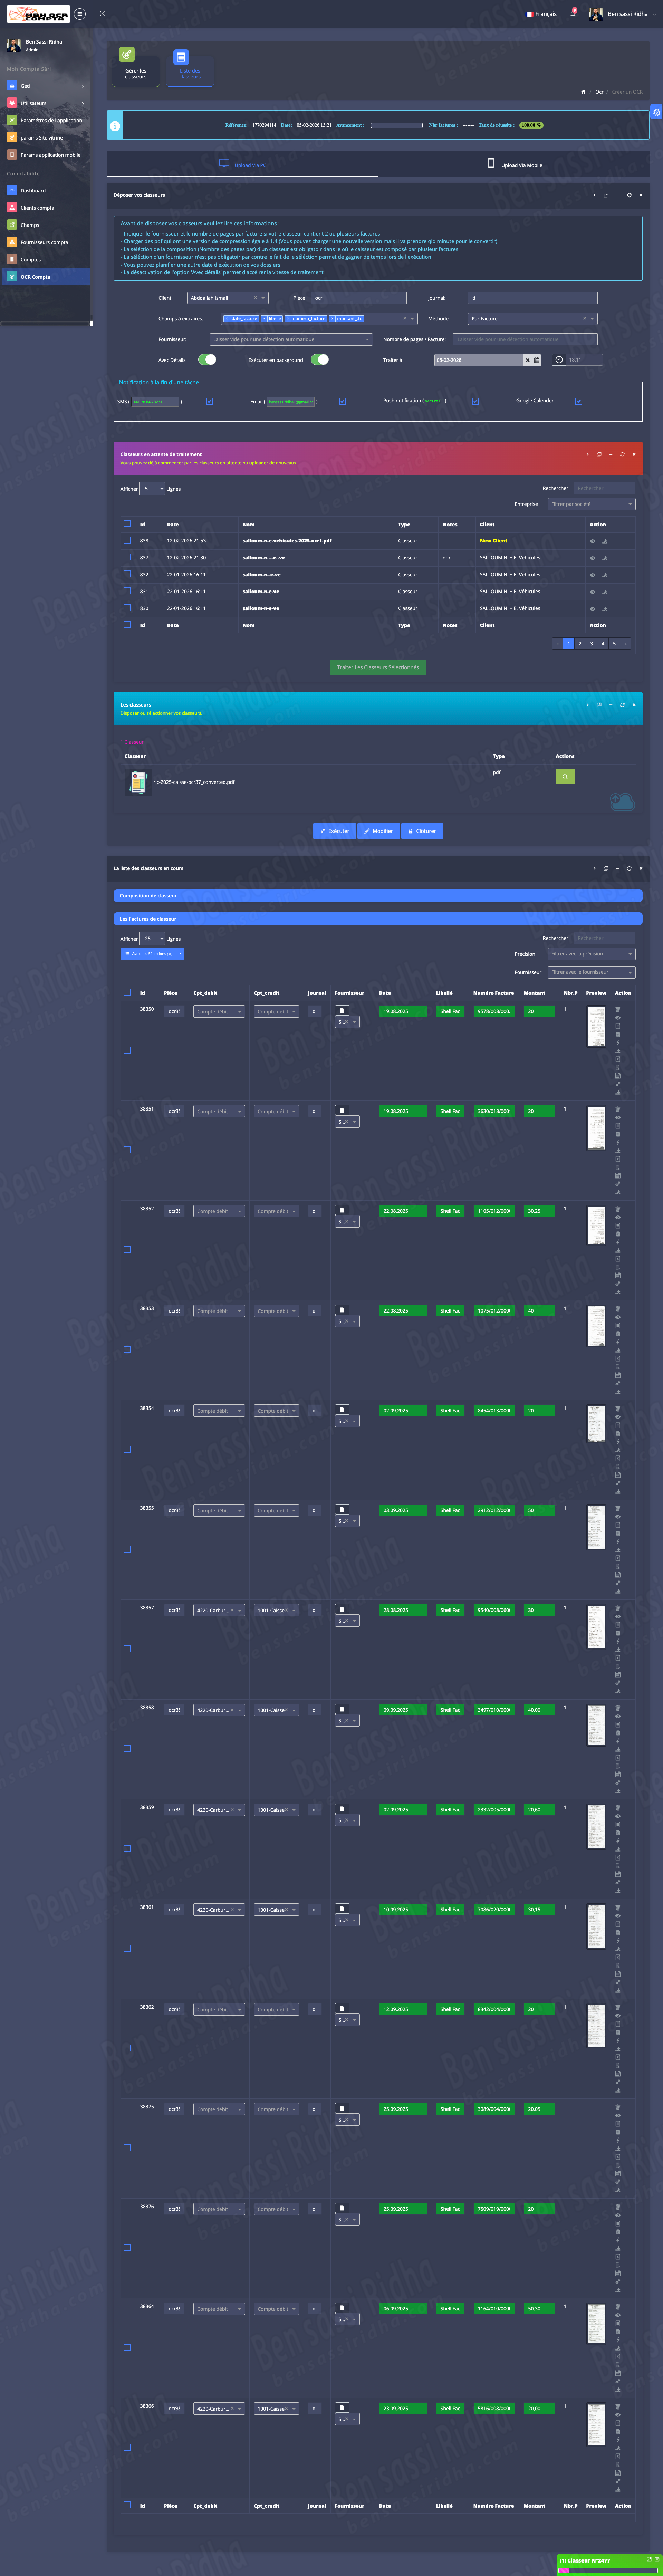
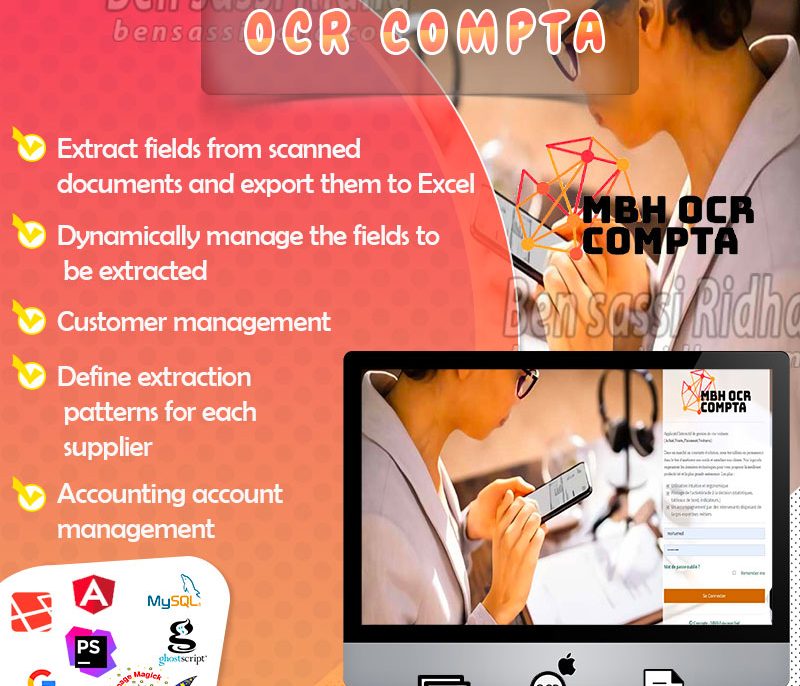
OCR COMPTA – Cette application web dédiée à des experts-comptables dans le but de sauver du temps dans le traitement de la facture liants. Il permet :
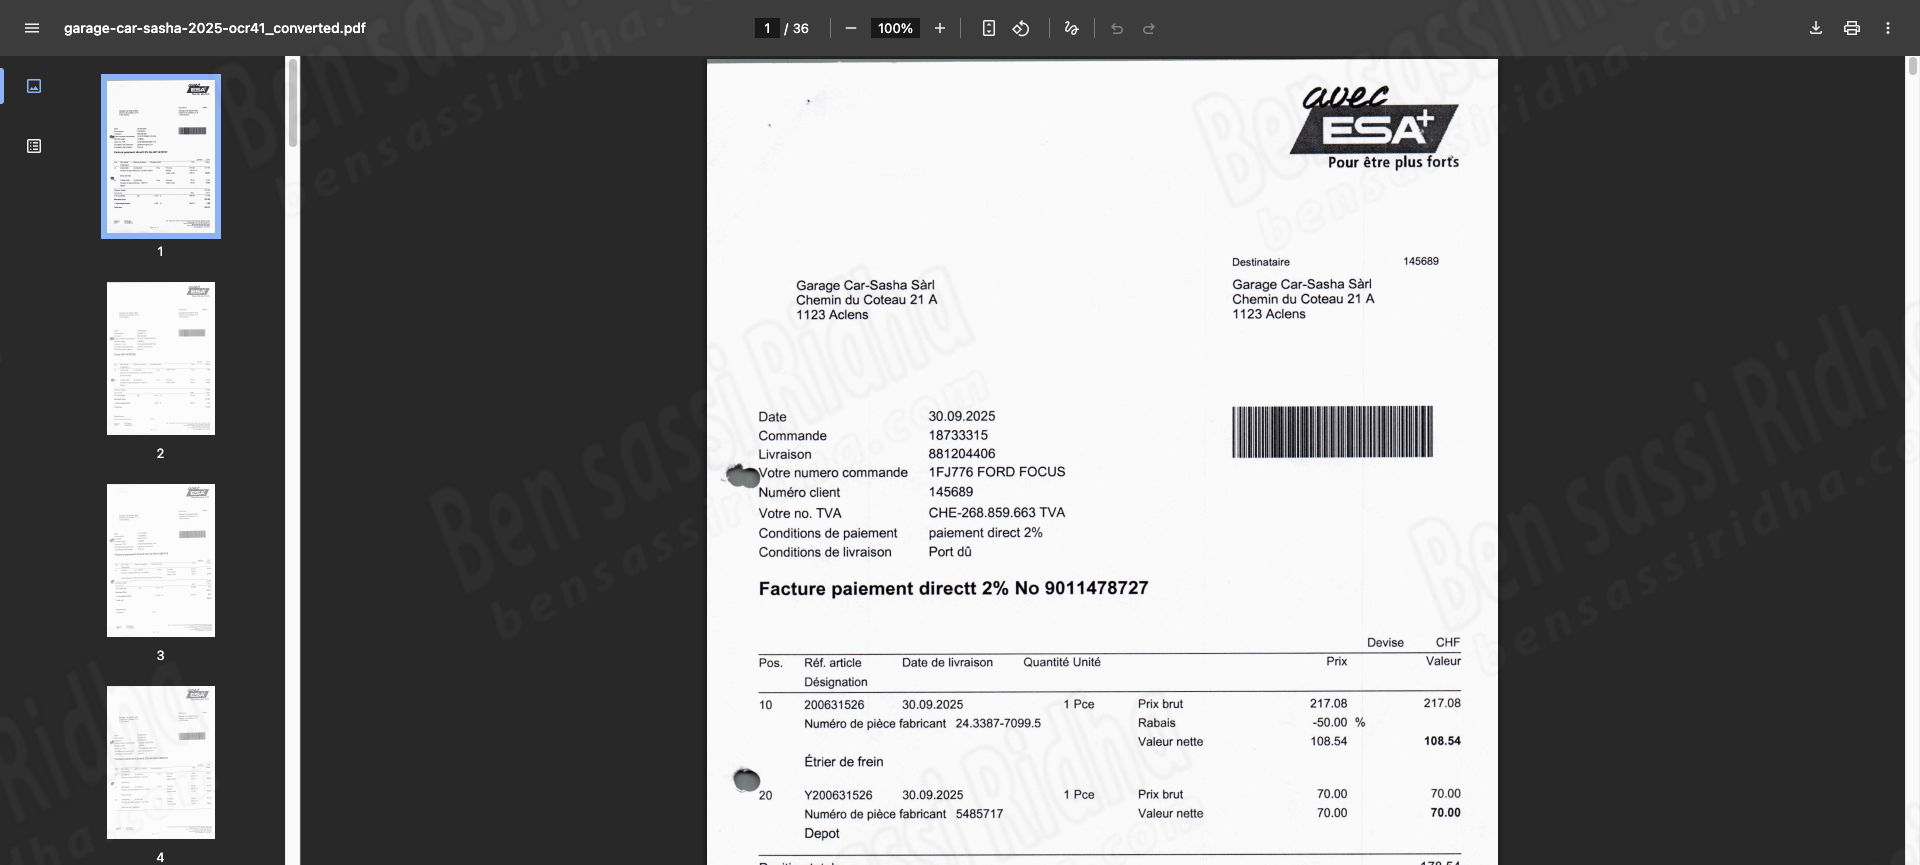
- L'Extraction de champs (par exemple, la TVA, le Montant ttc de la facture, etc.) rapidement de factures en image ou en format PDF
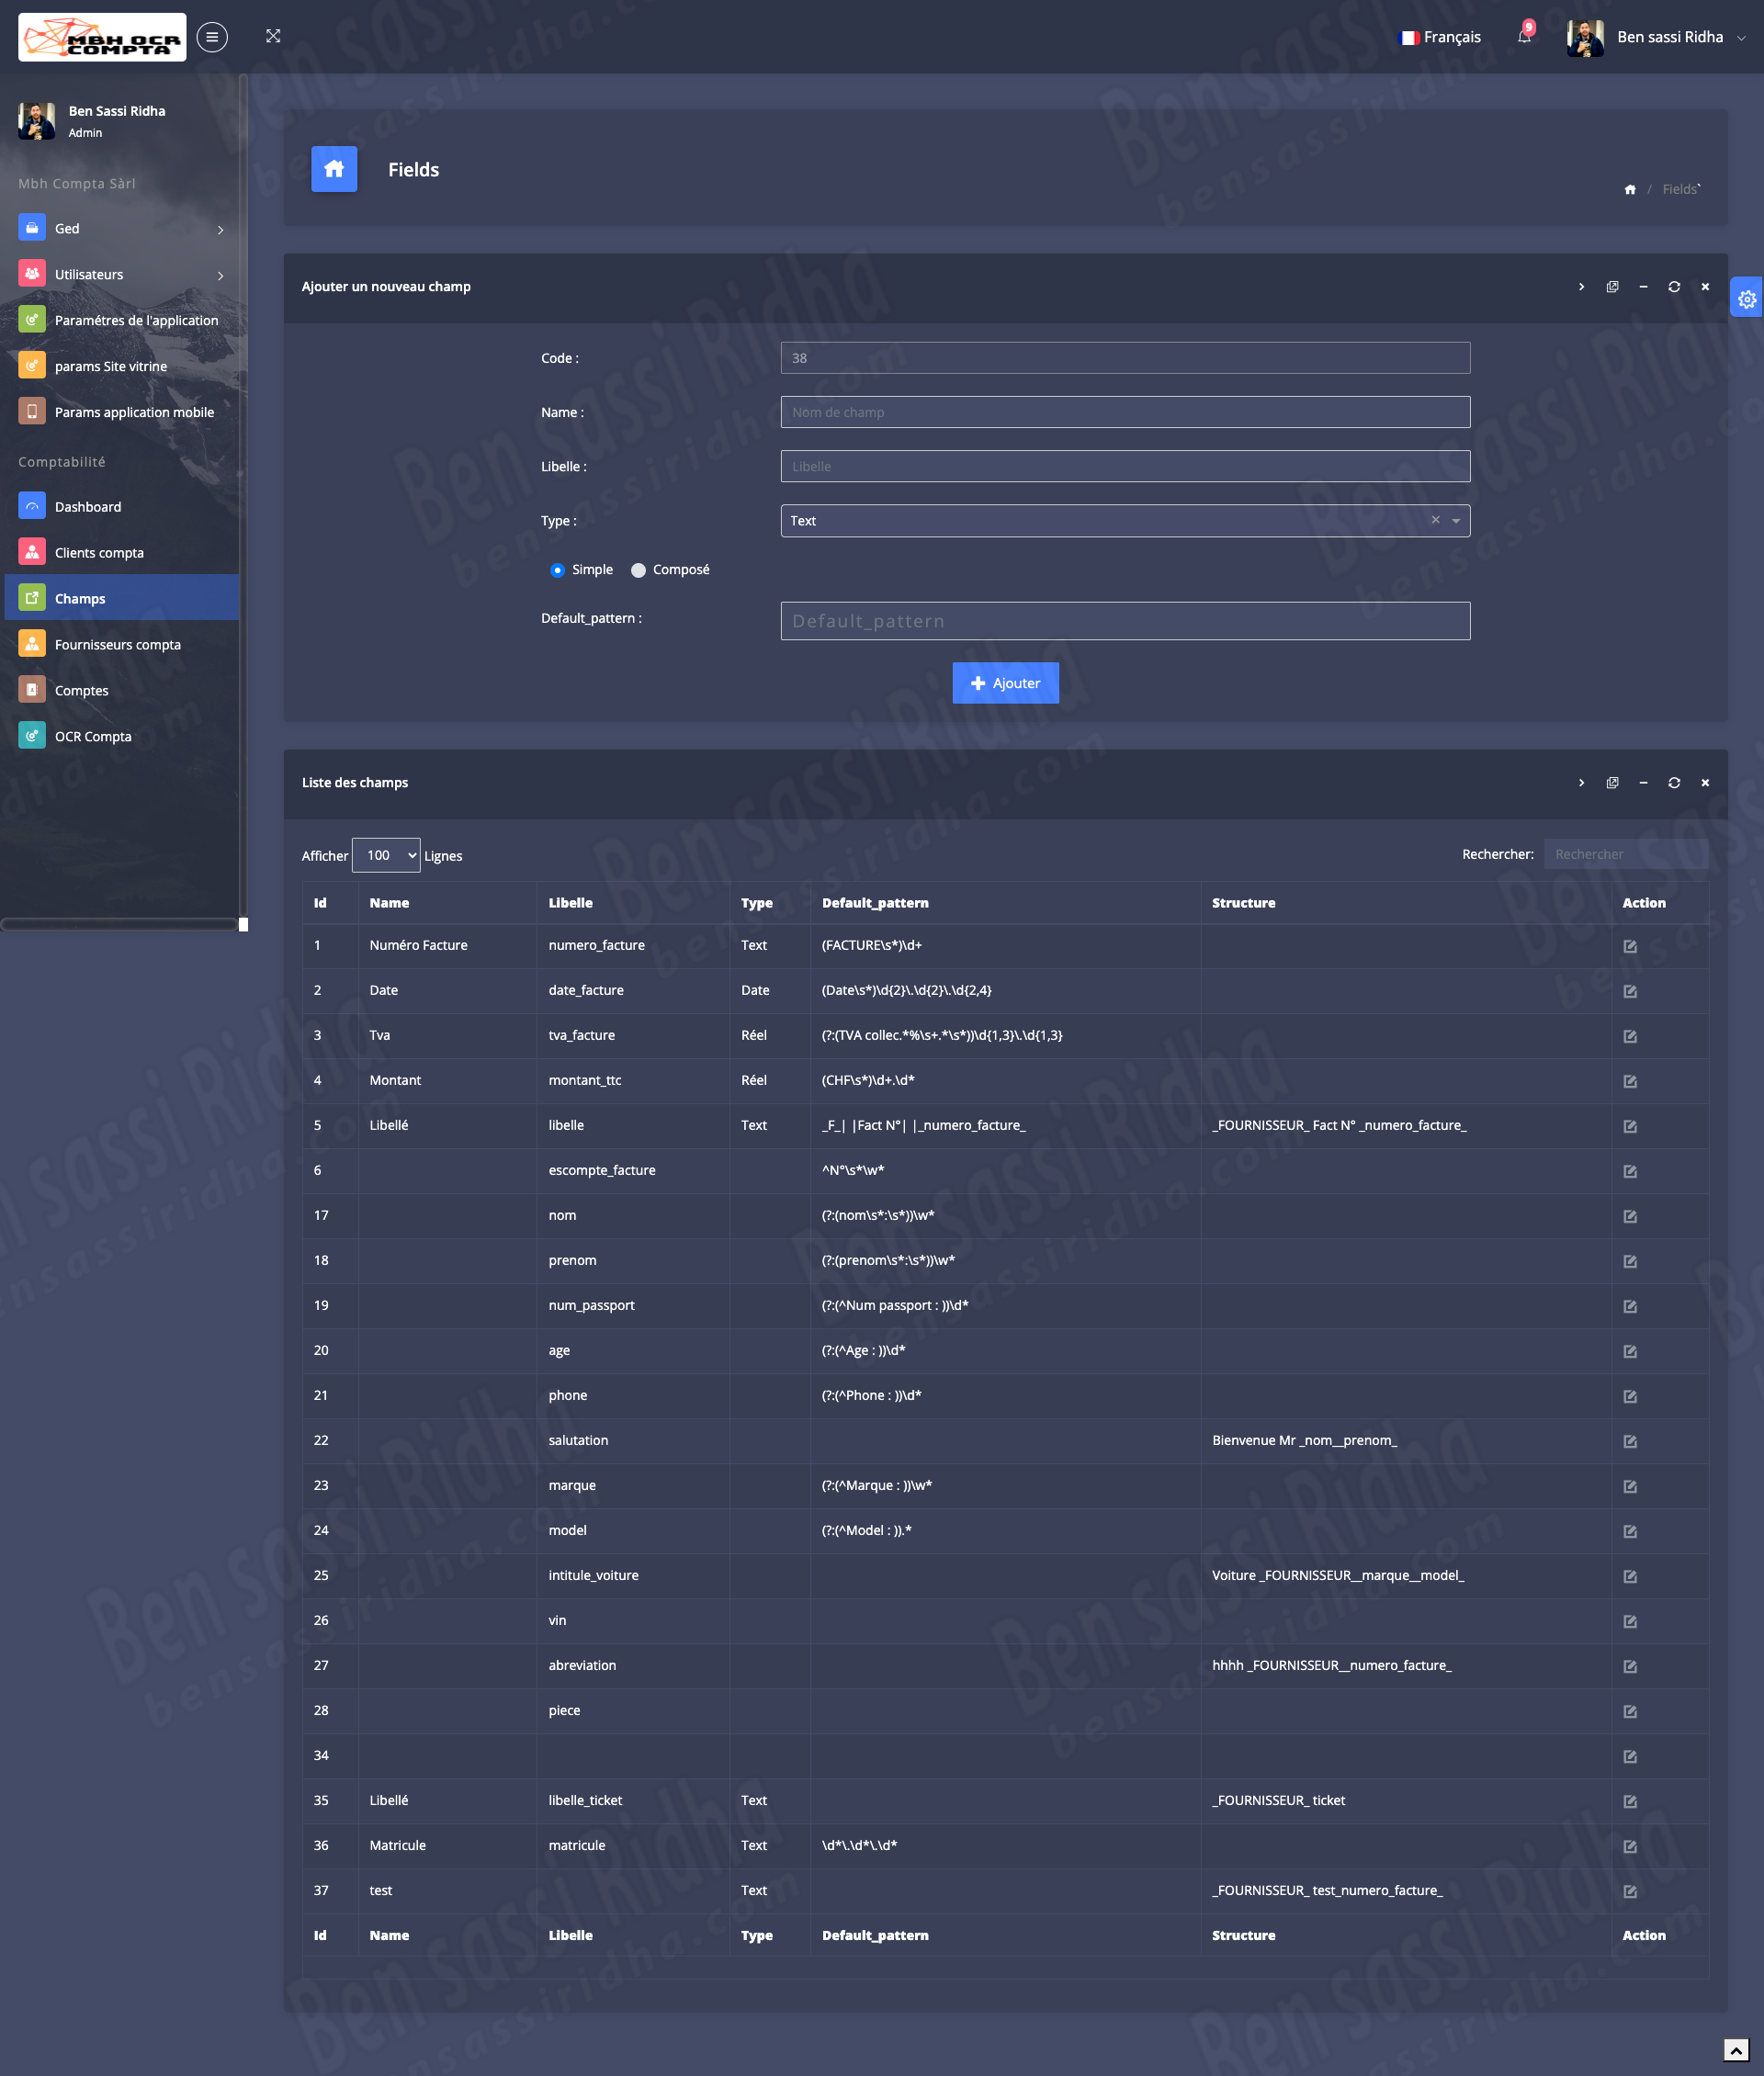
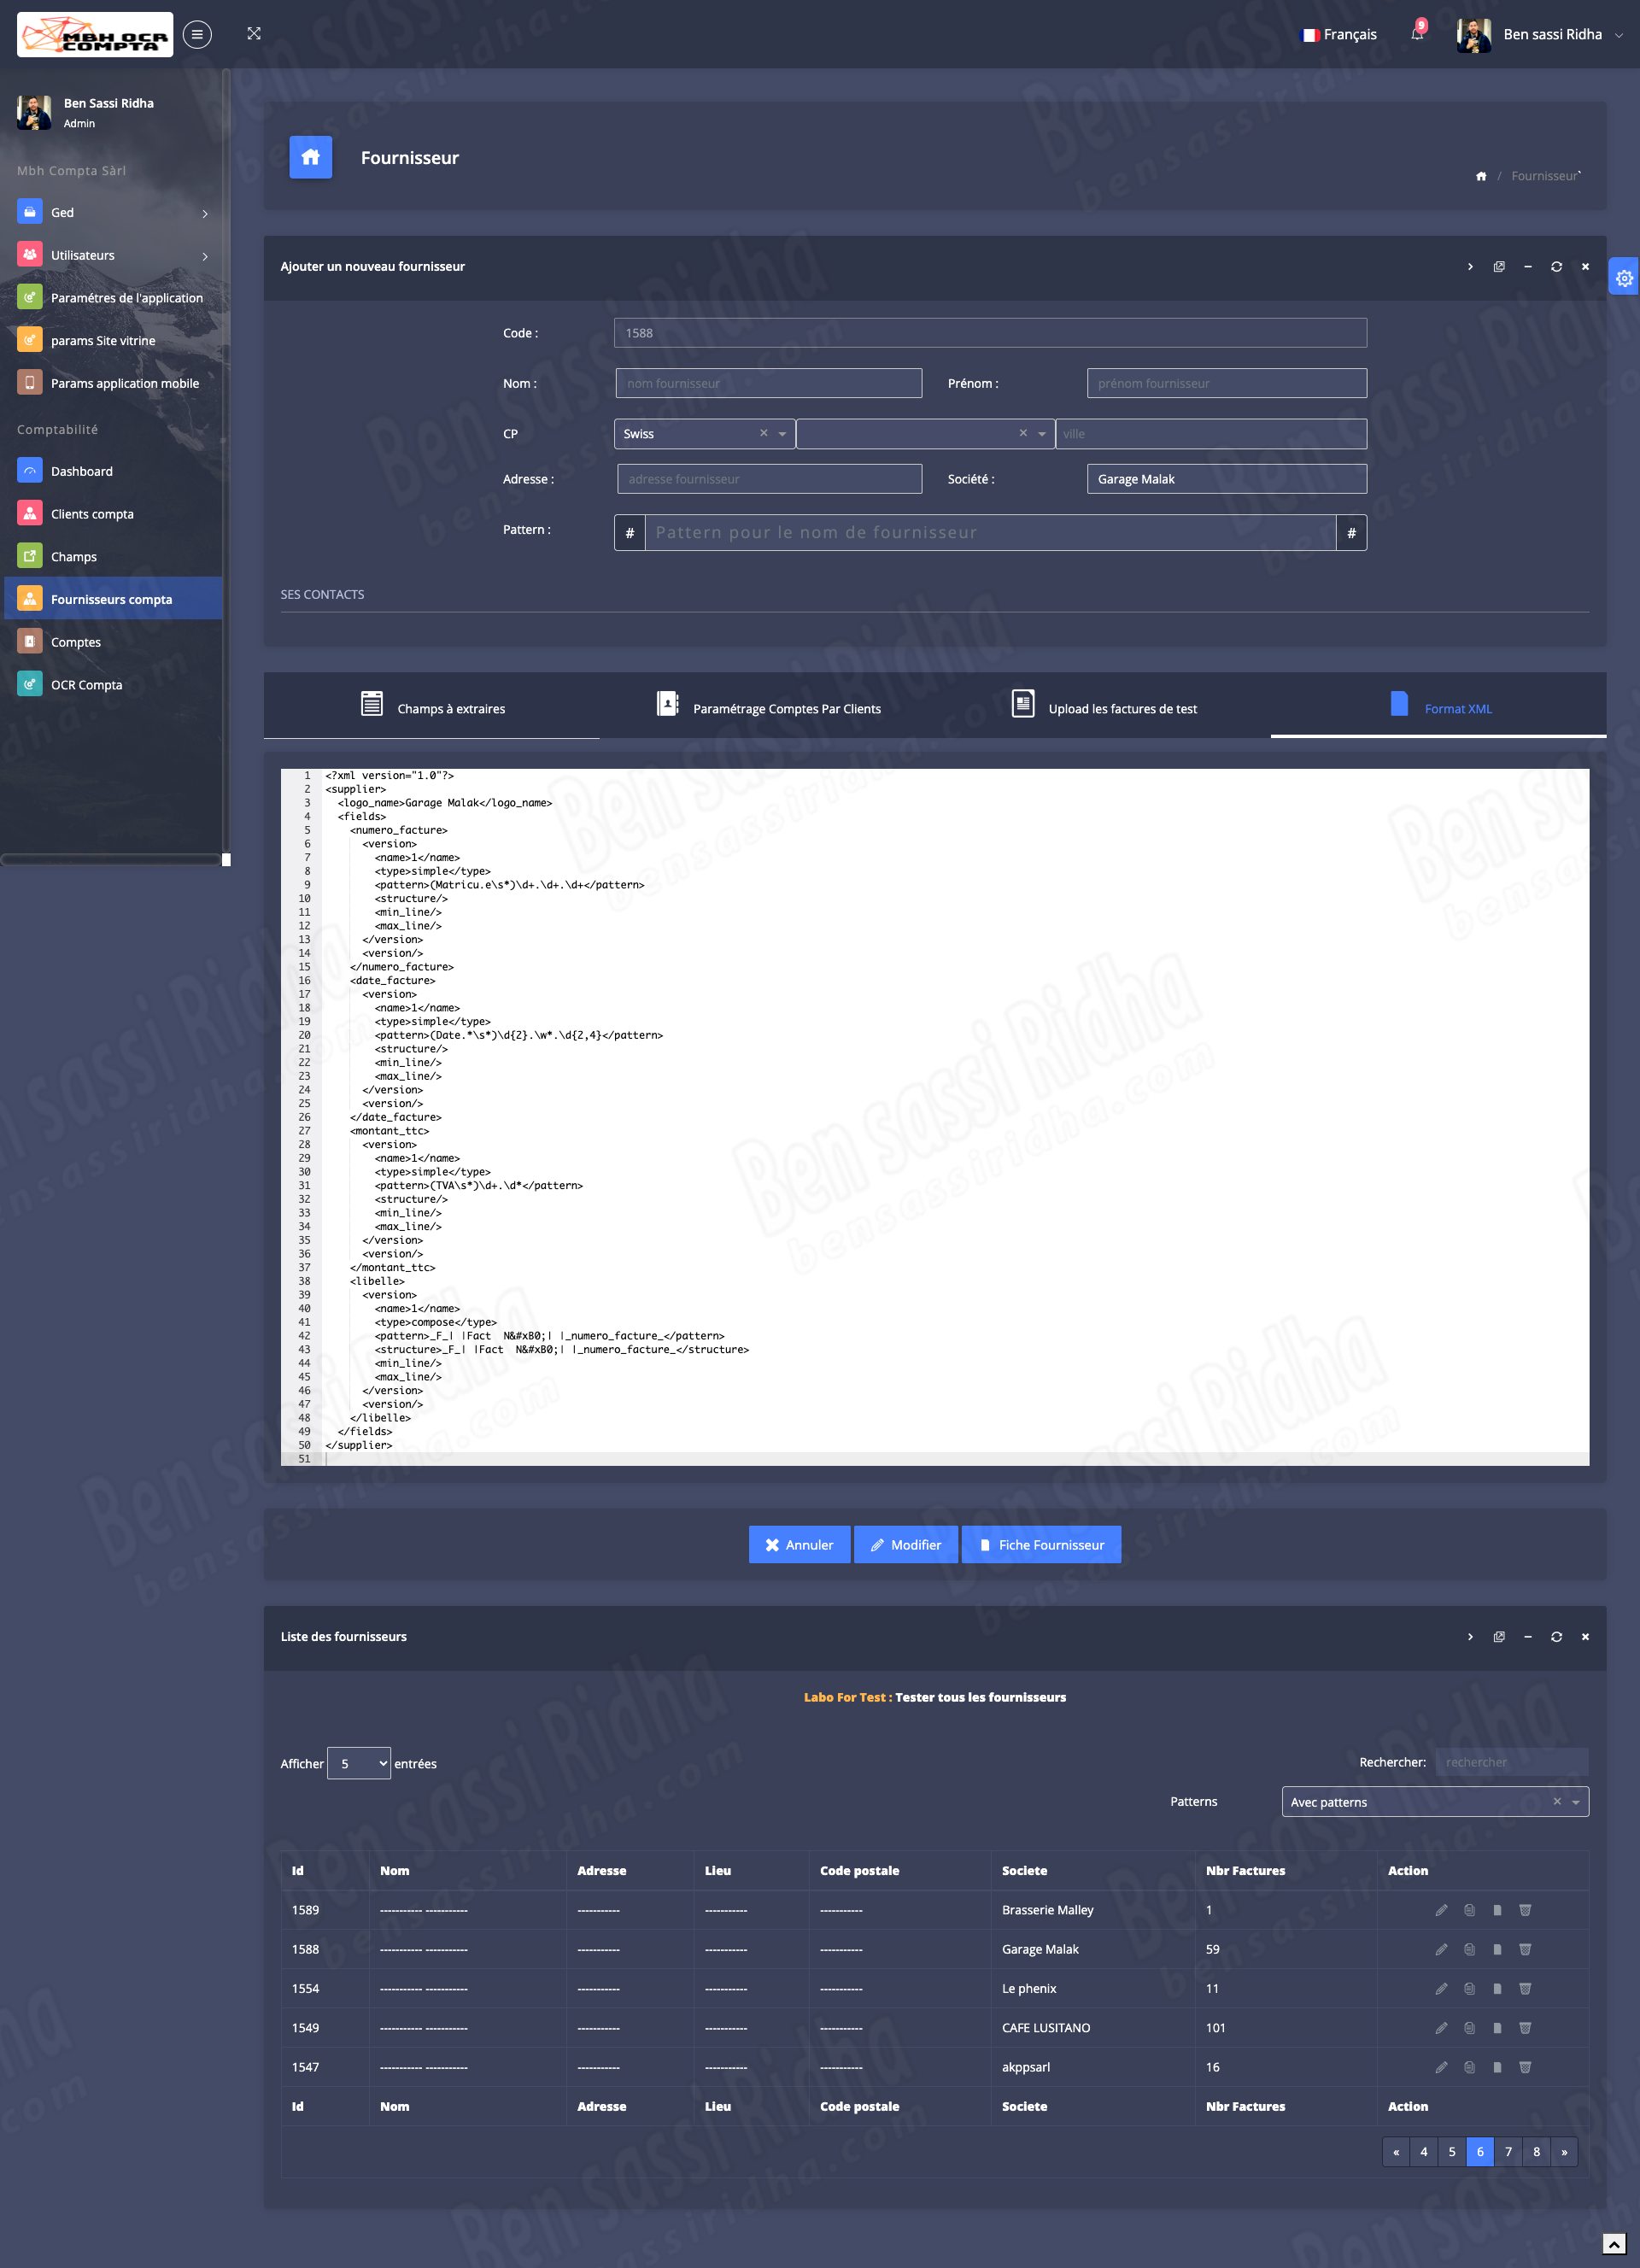
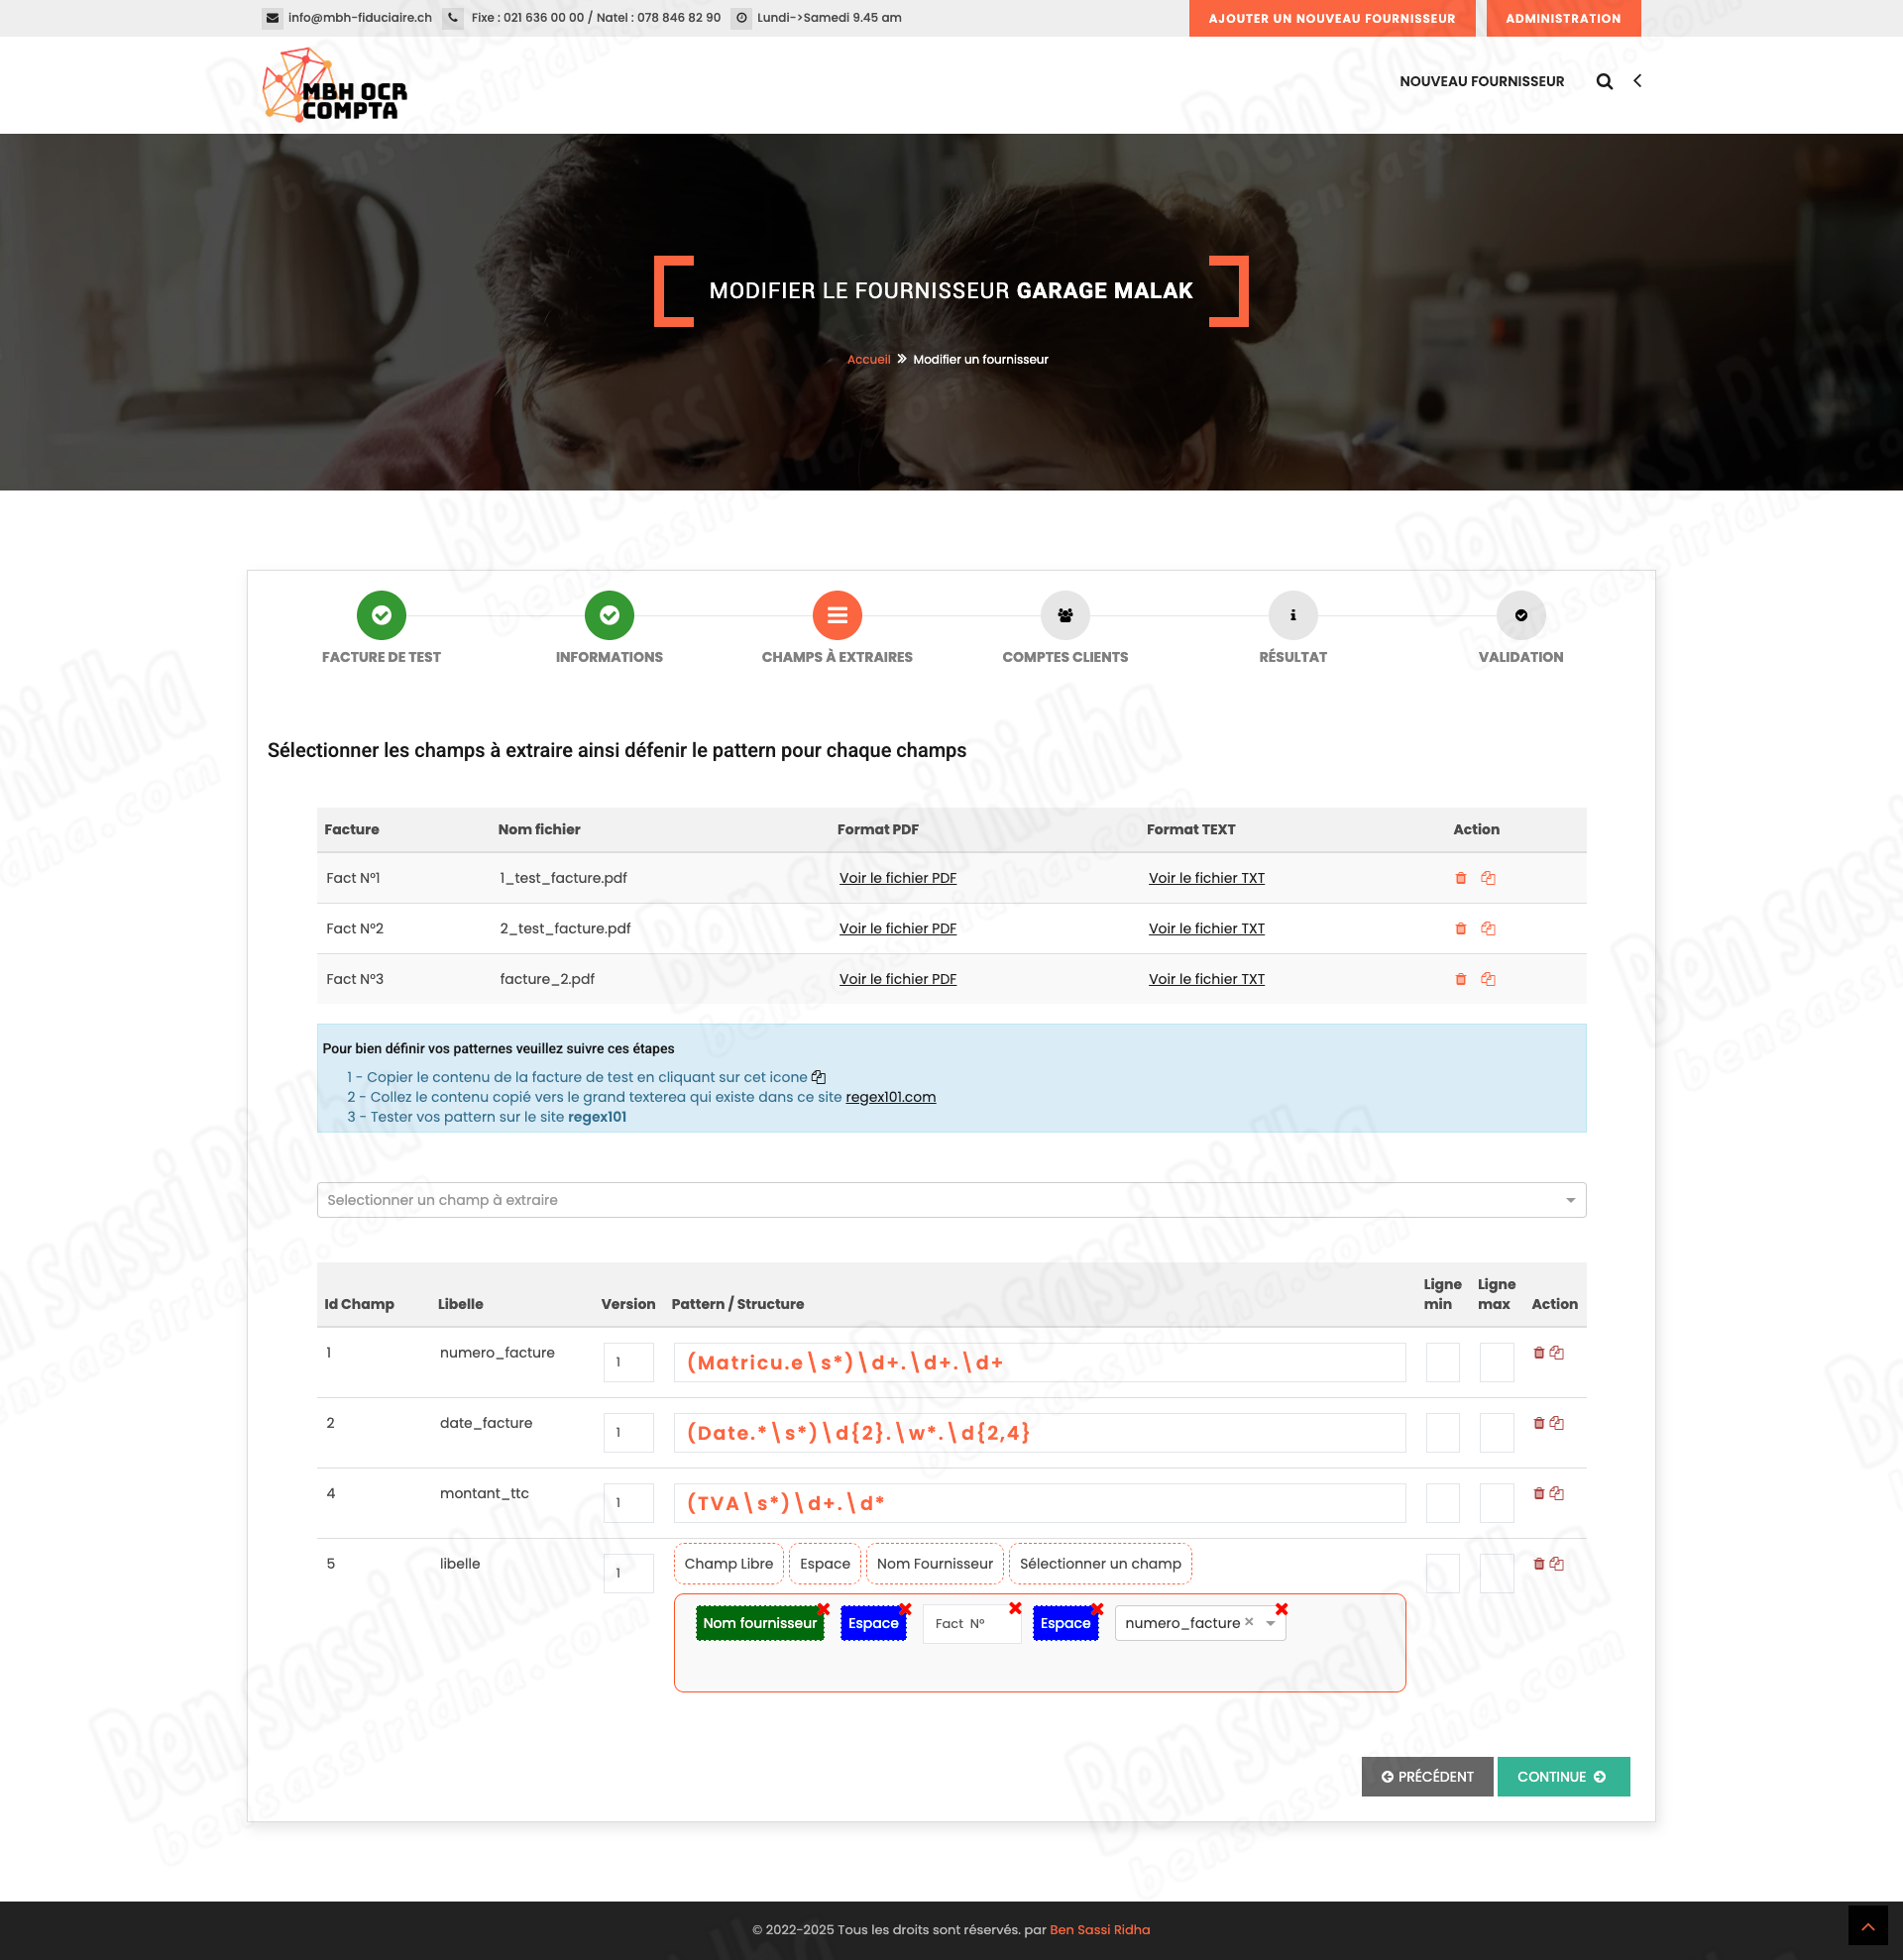
- Gestion dynamique des champs à extraire et à leurs modes
- Gérer la possibilité de disposer de plusieurs versions pour chaque champ
- Gérer des champs simples et composés de champs qui sont composés d'autres domaines (par exemple; label = Non. numFactSupplierName)
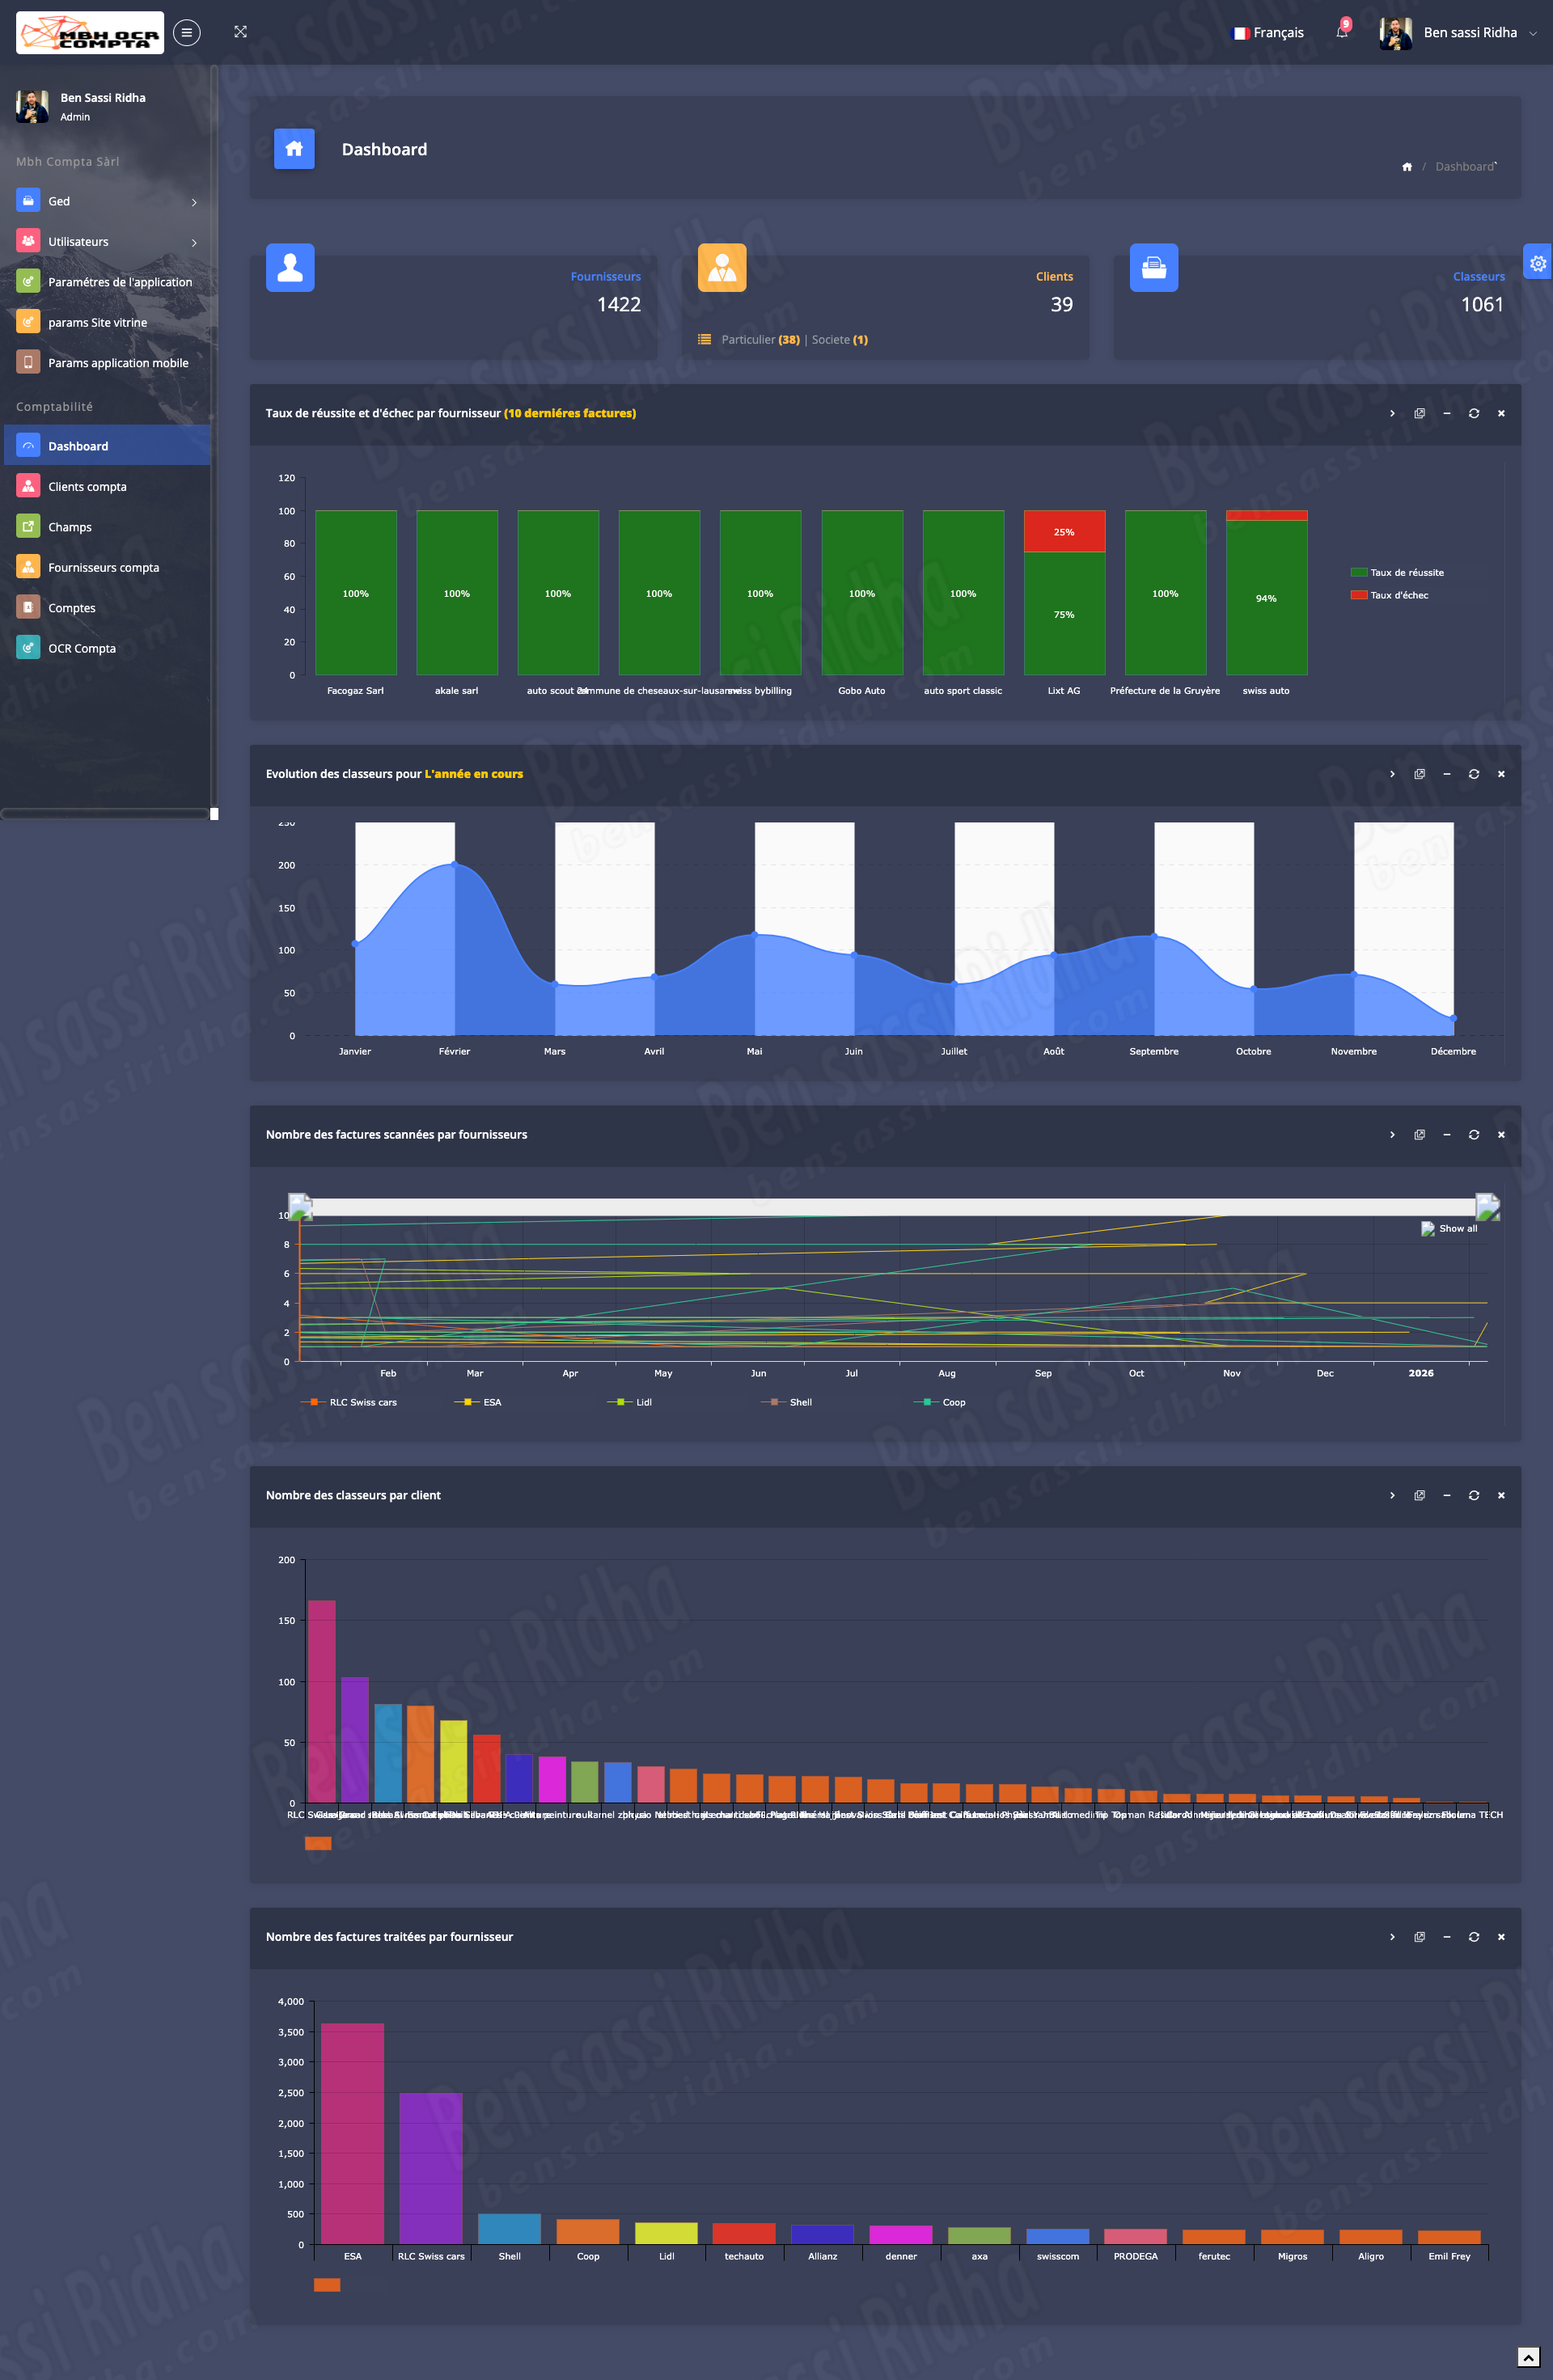
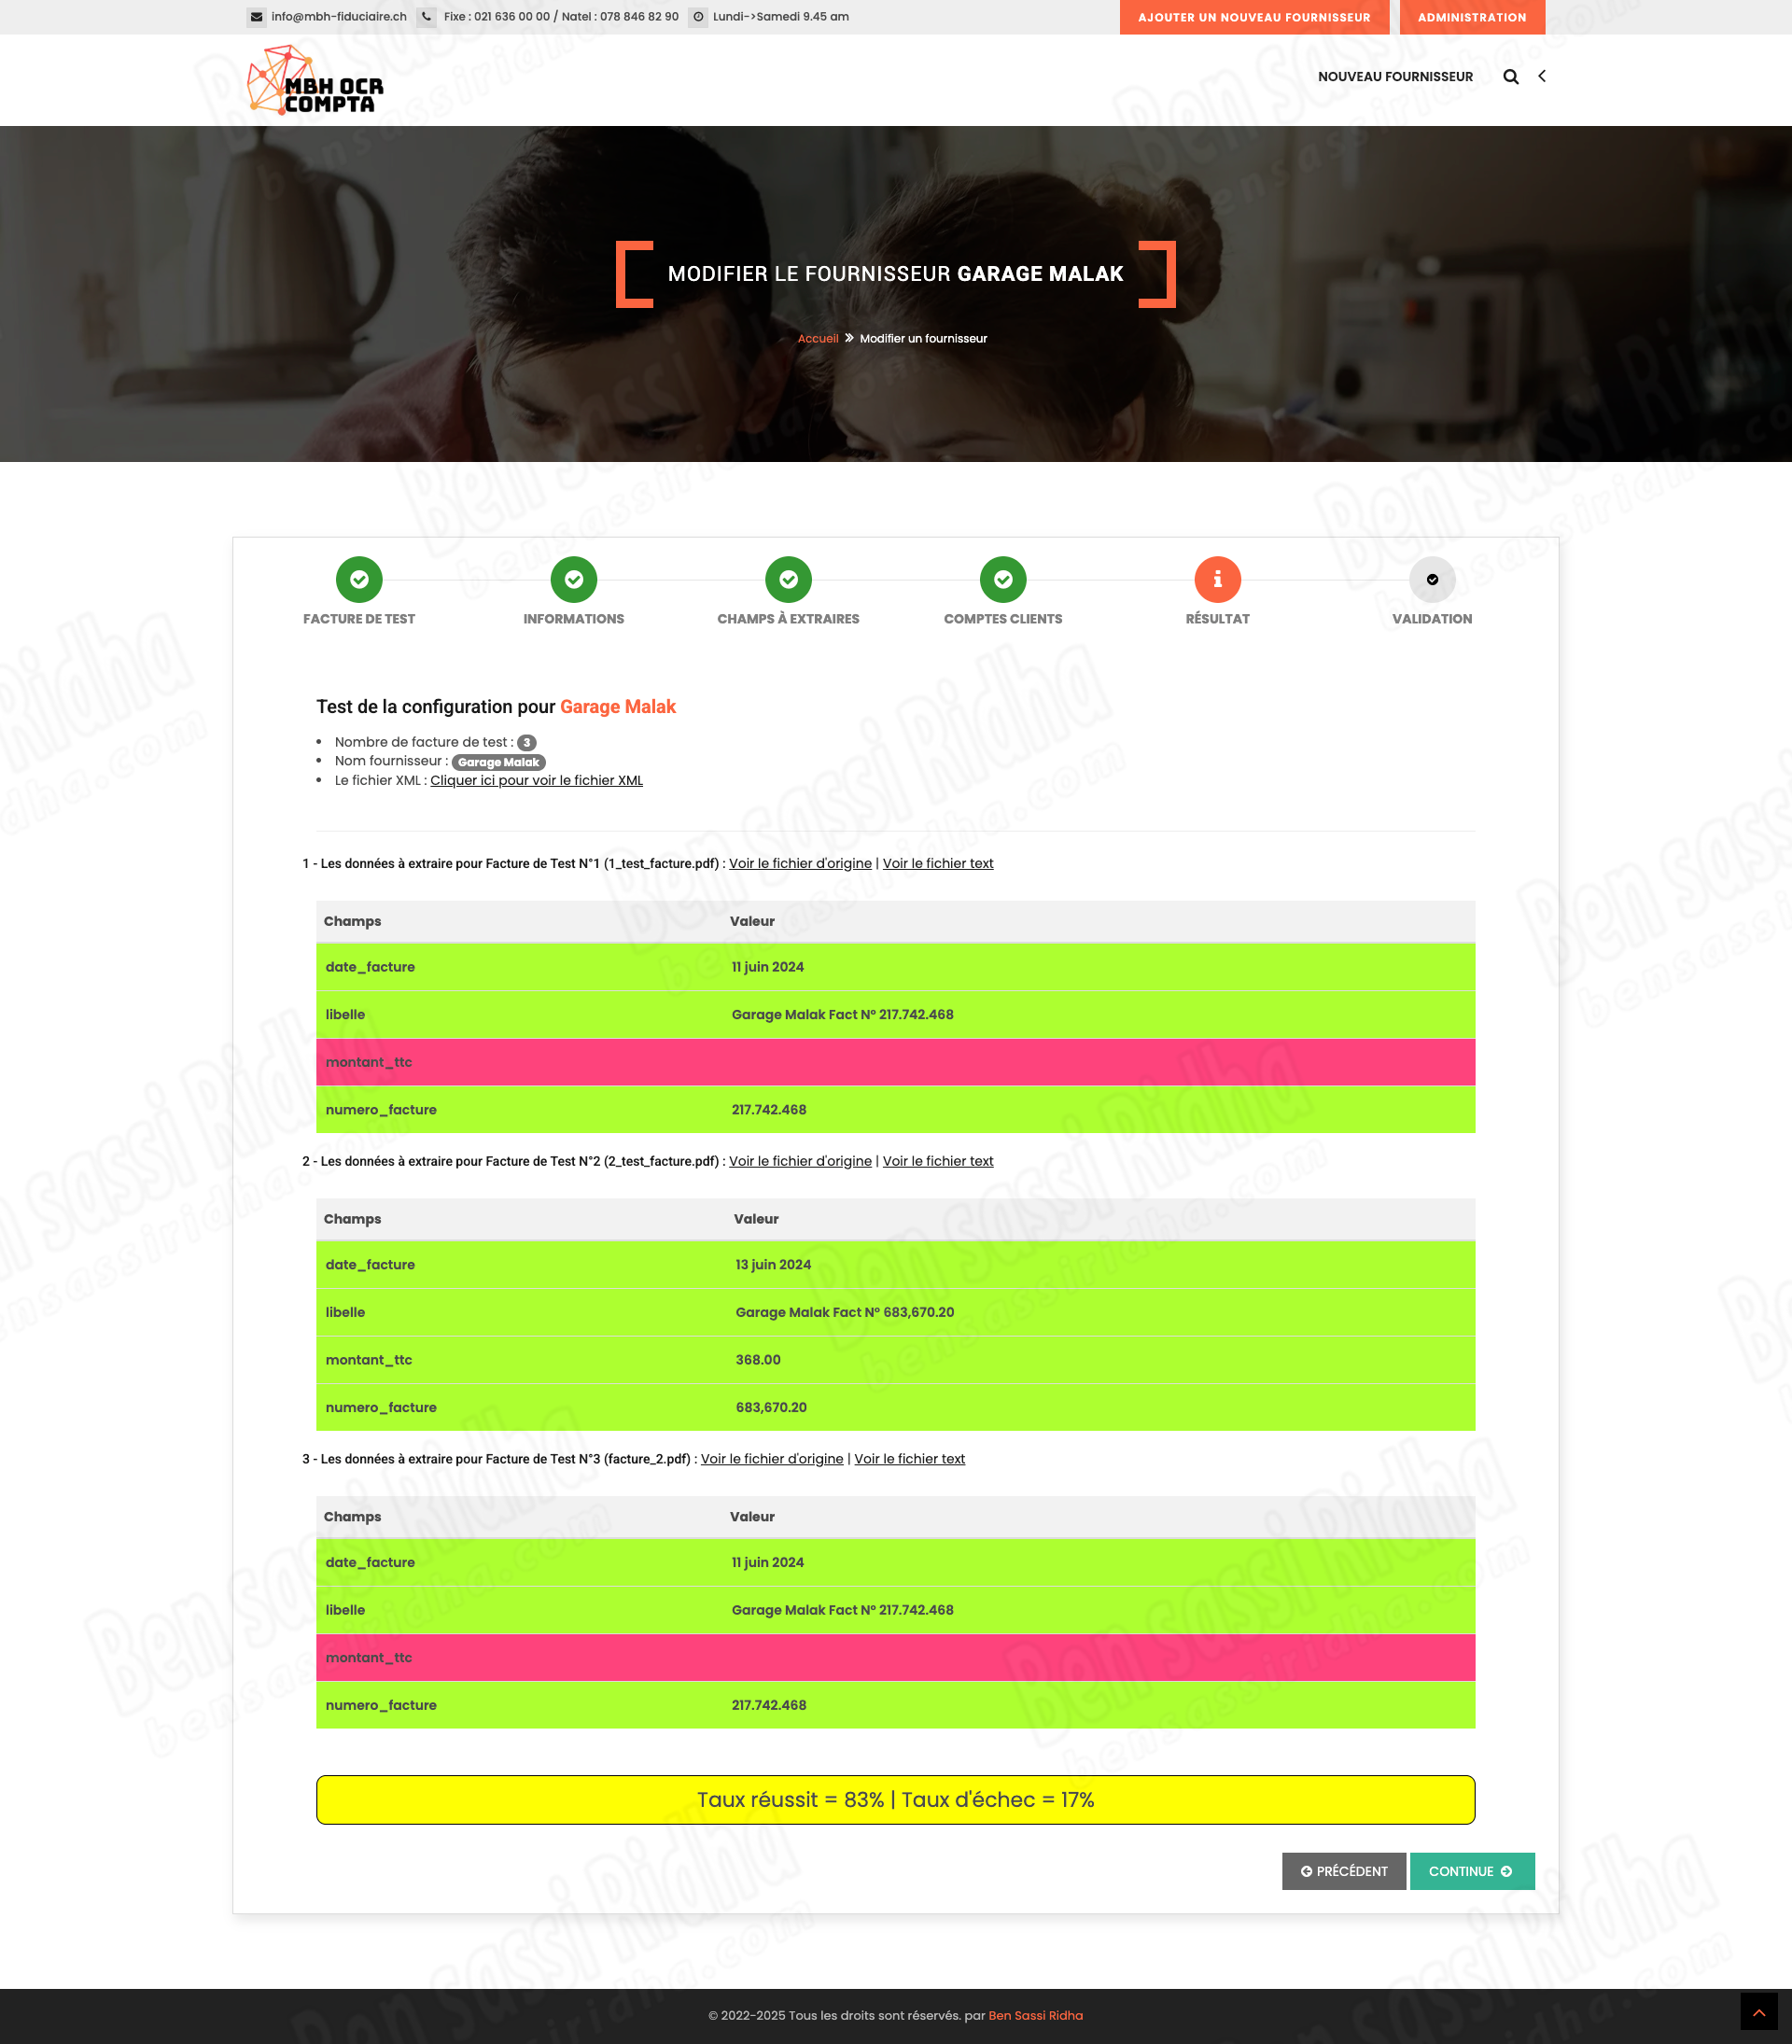
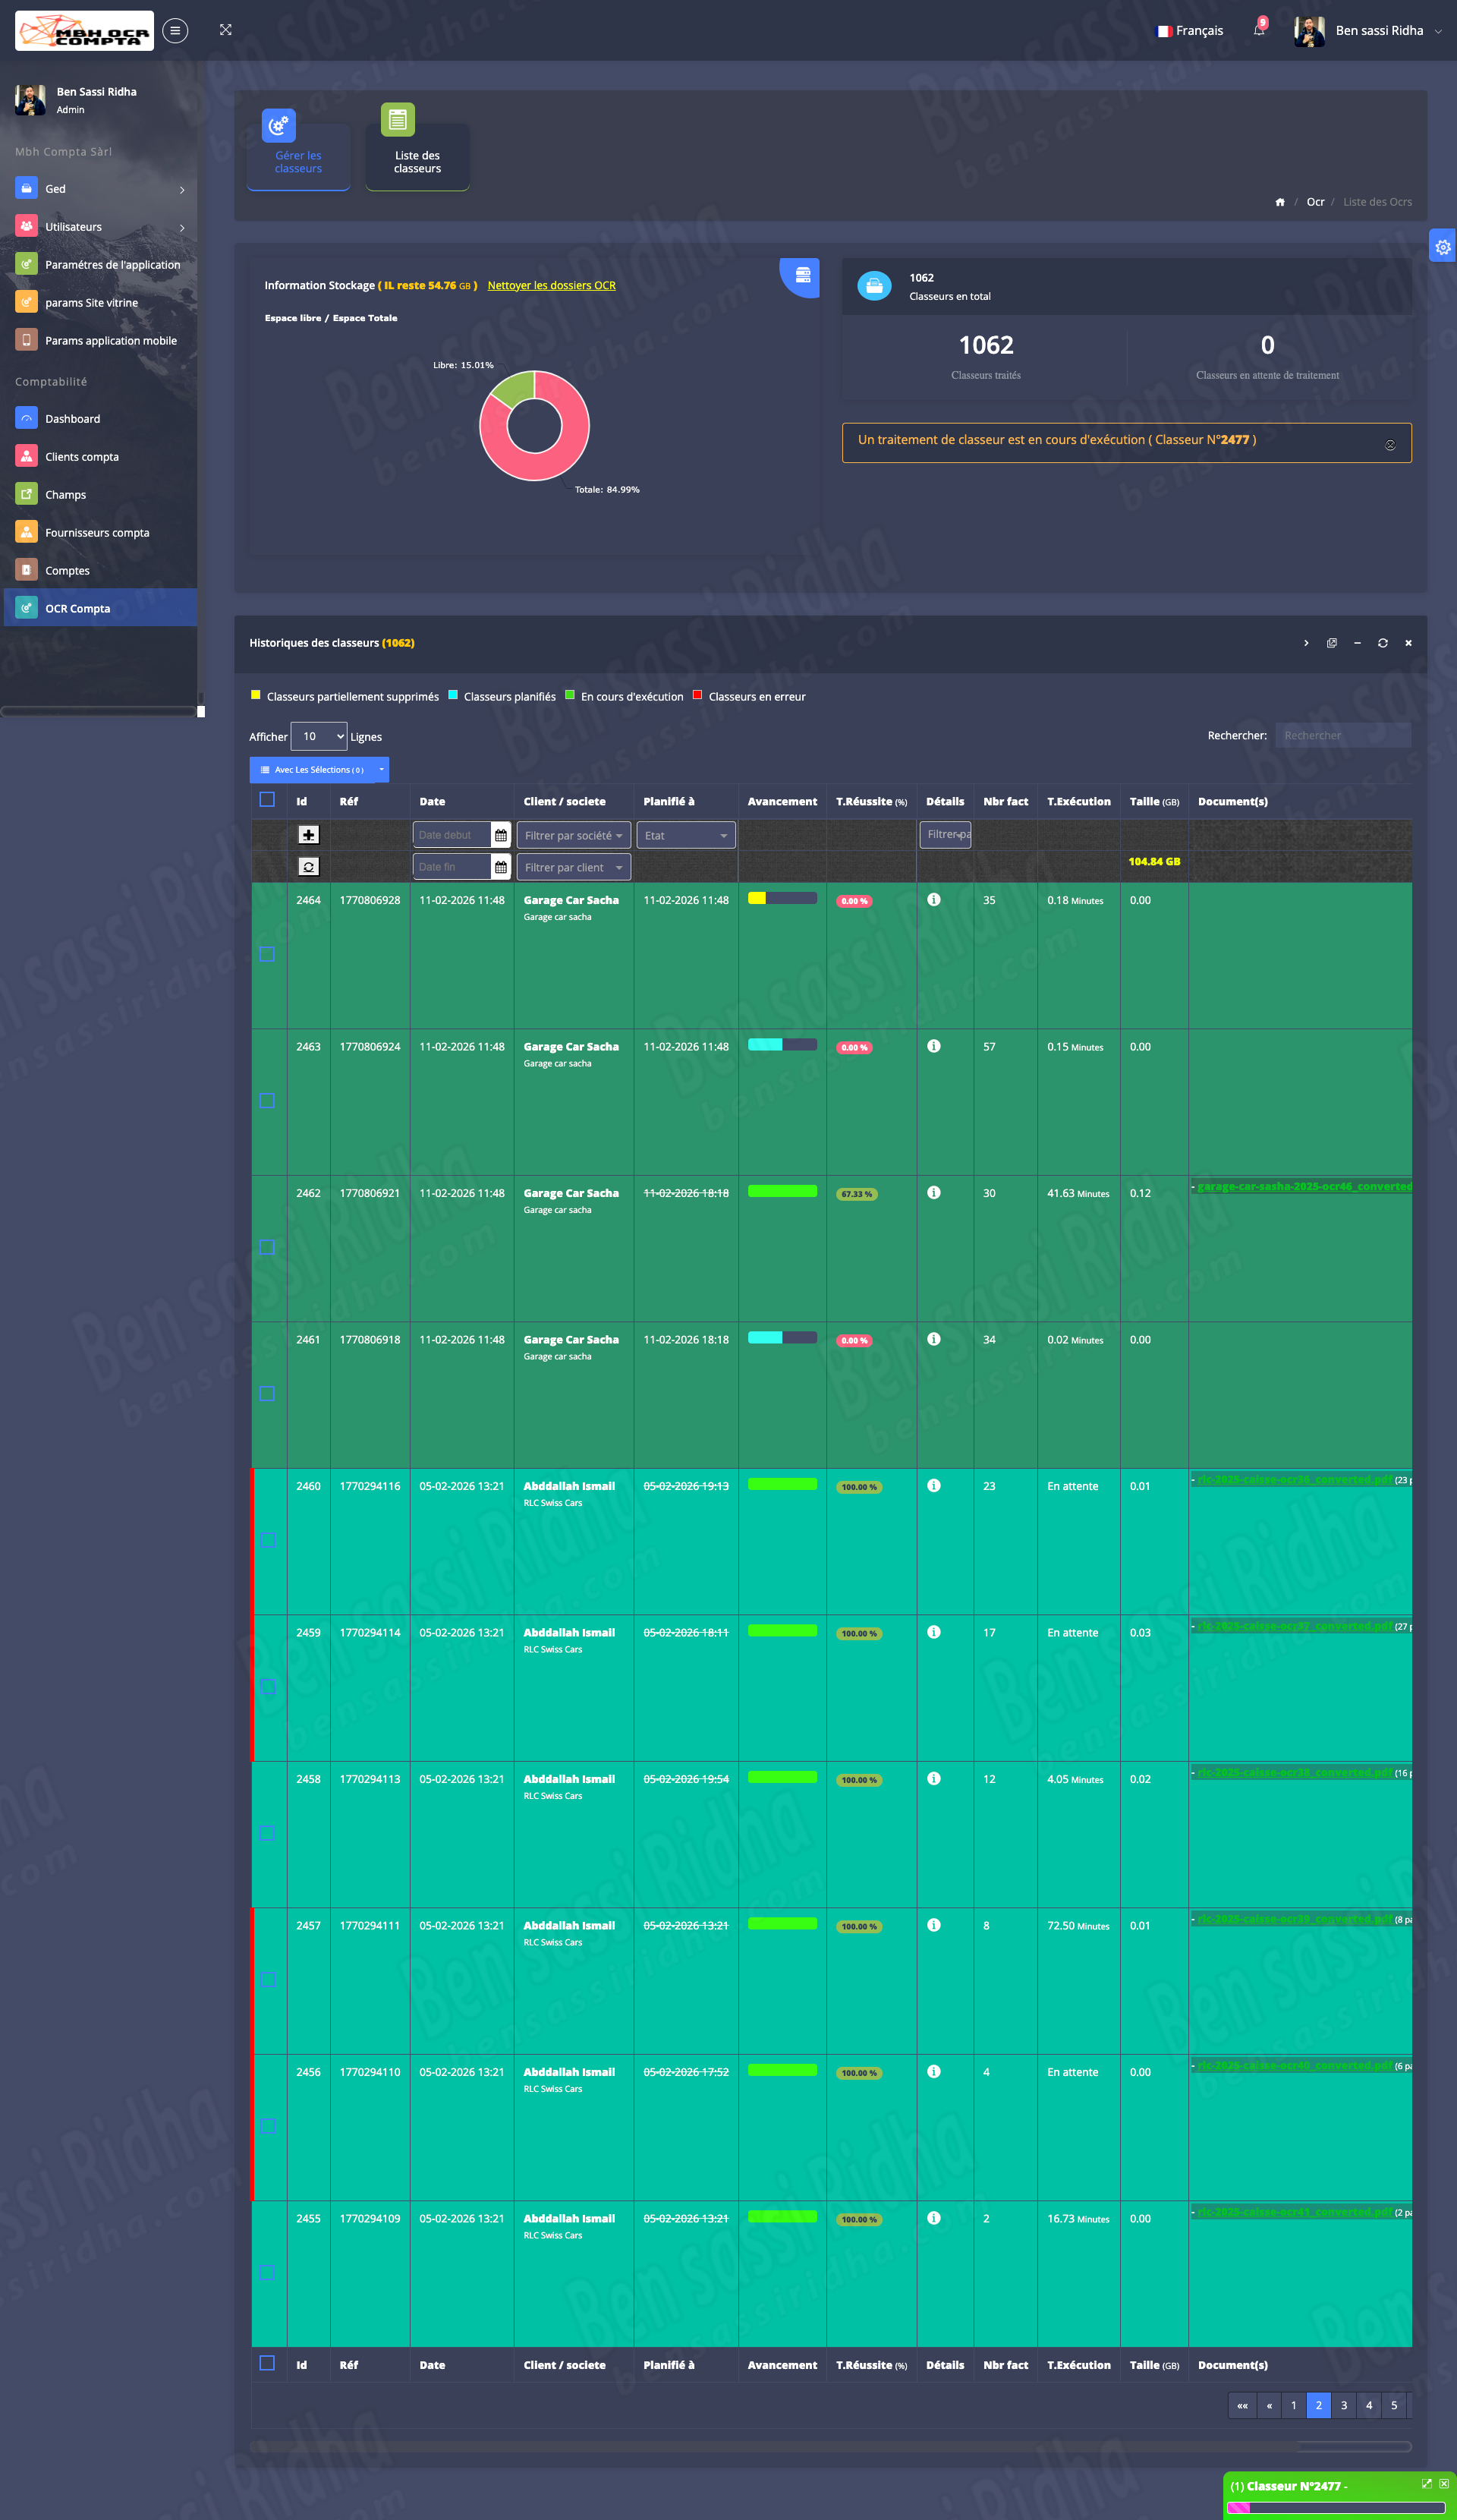
- Afficher les chiffres clés telles que la détection de champ de réussite et les taux de défaillance pour chaque fournisseur
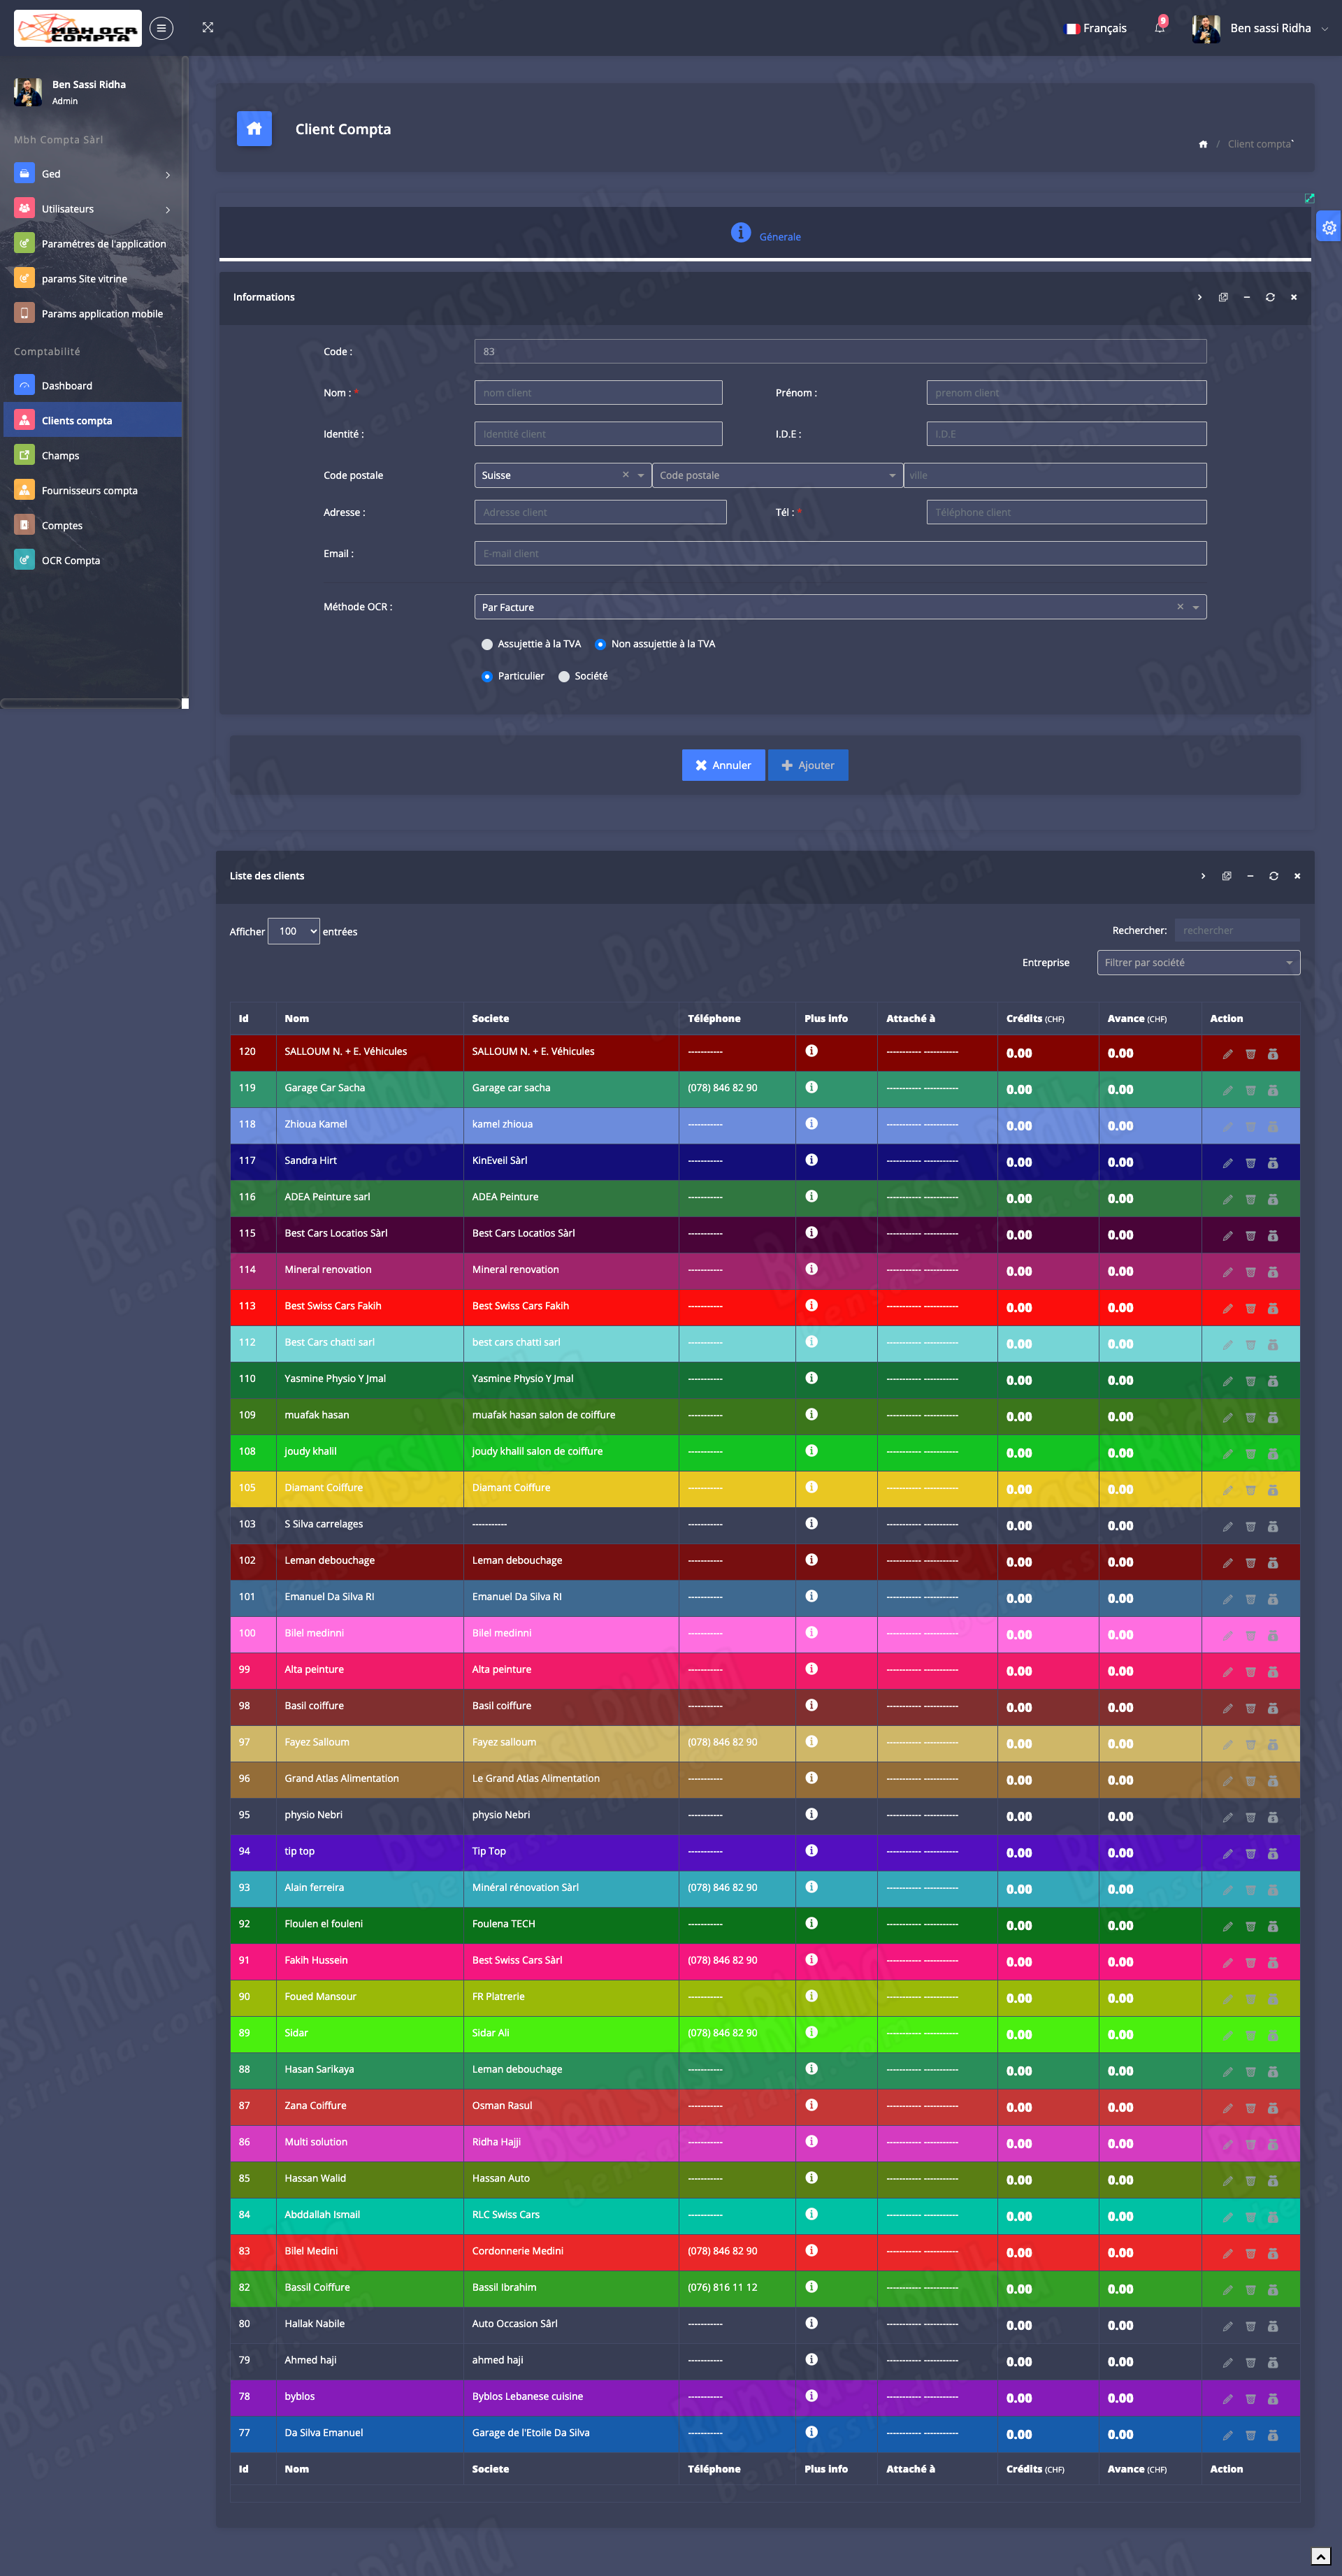
- Gérer les clients
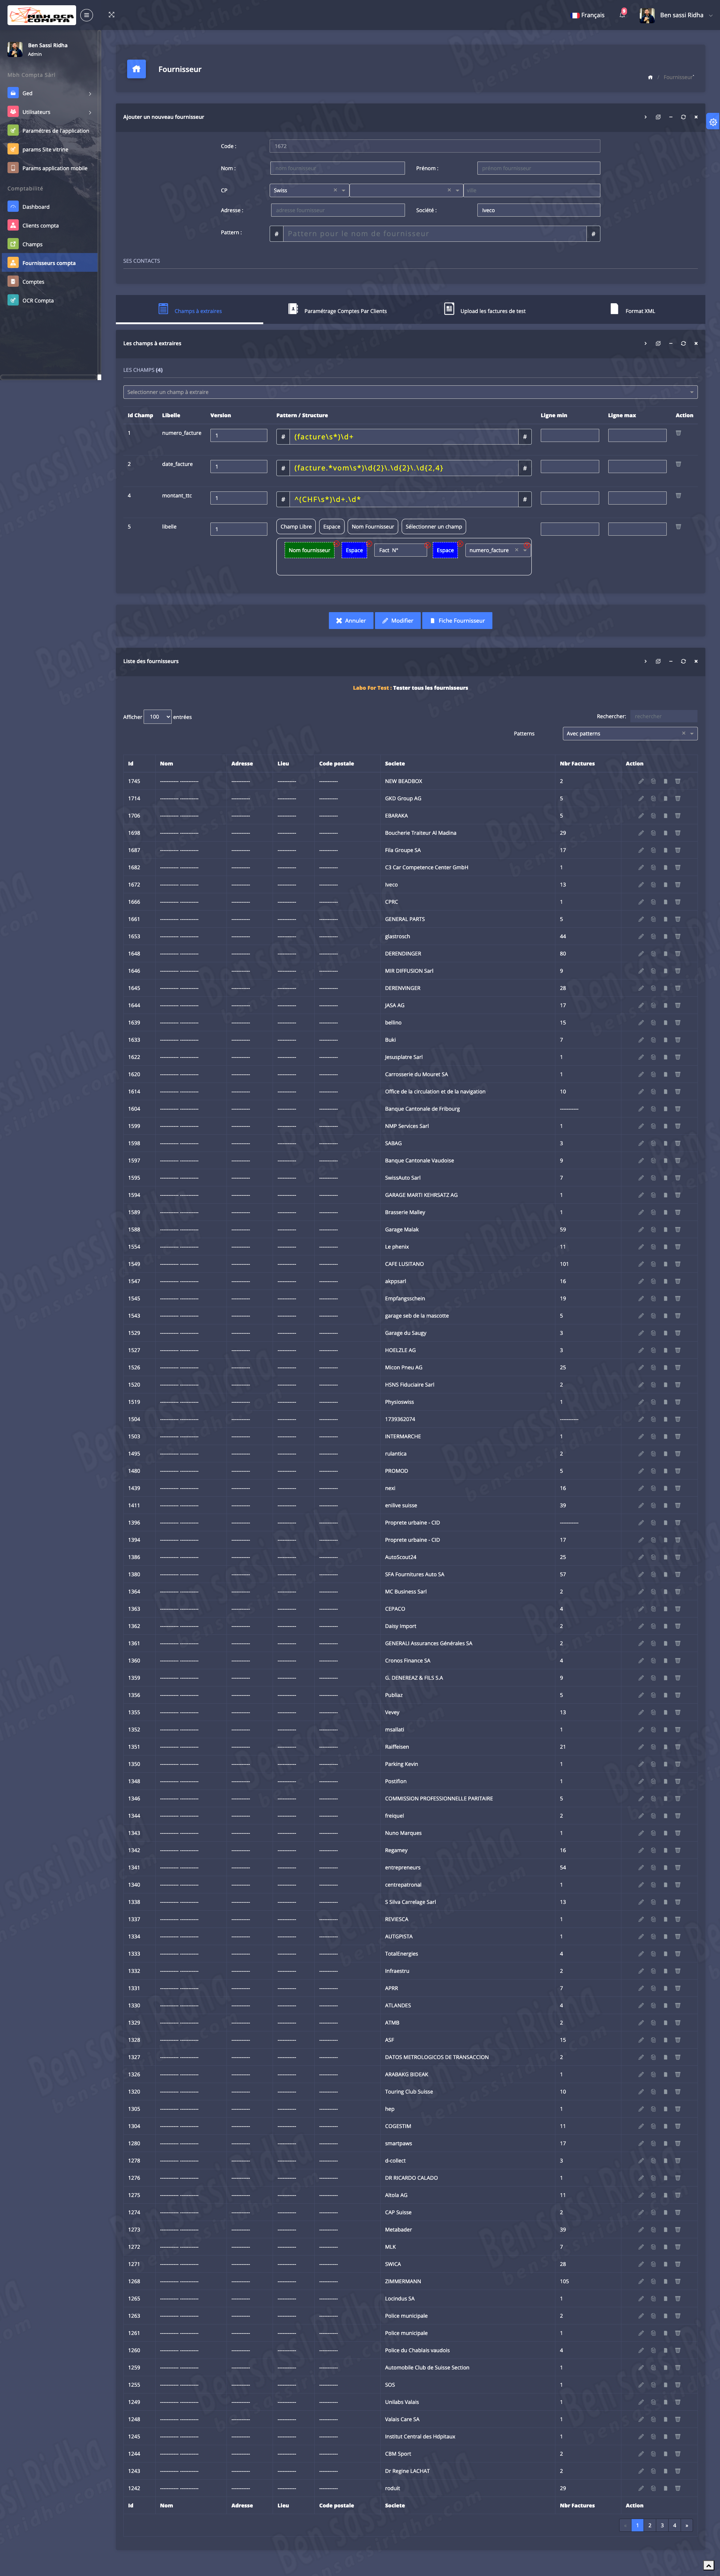
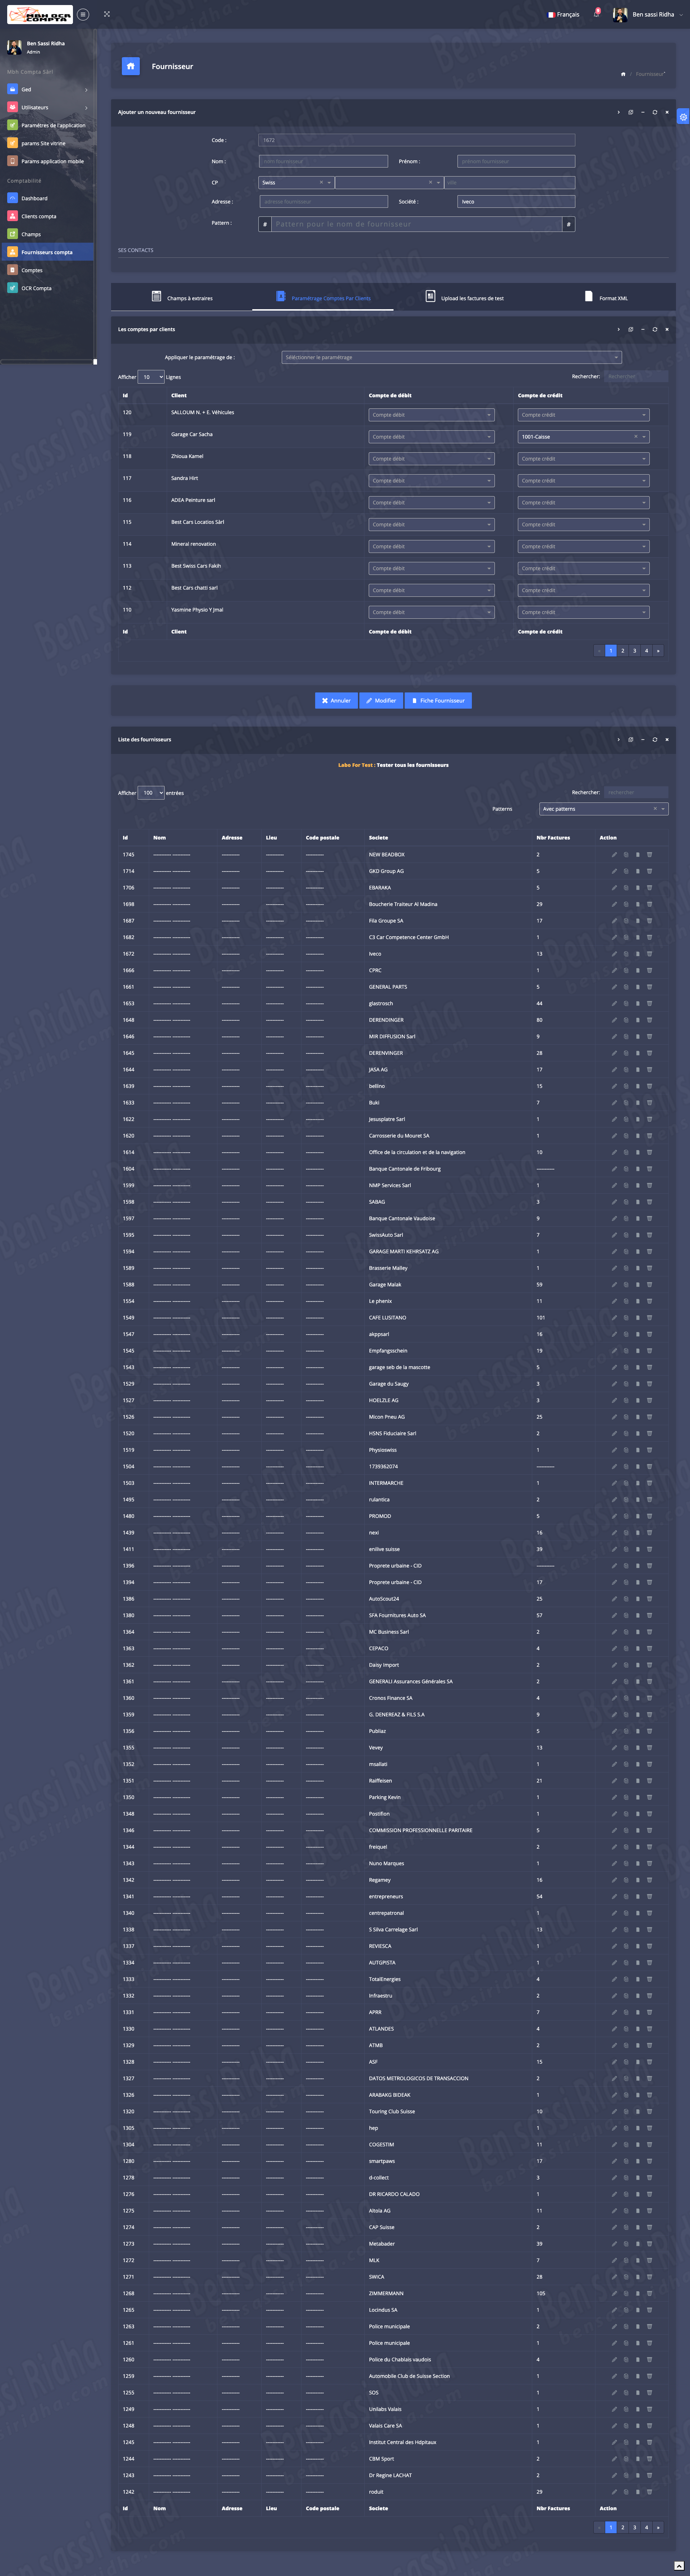
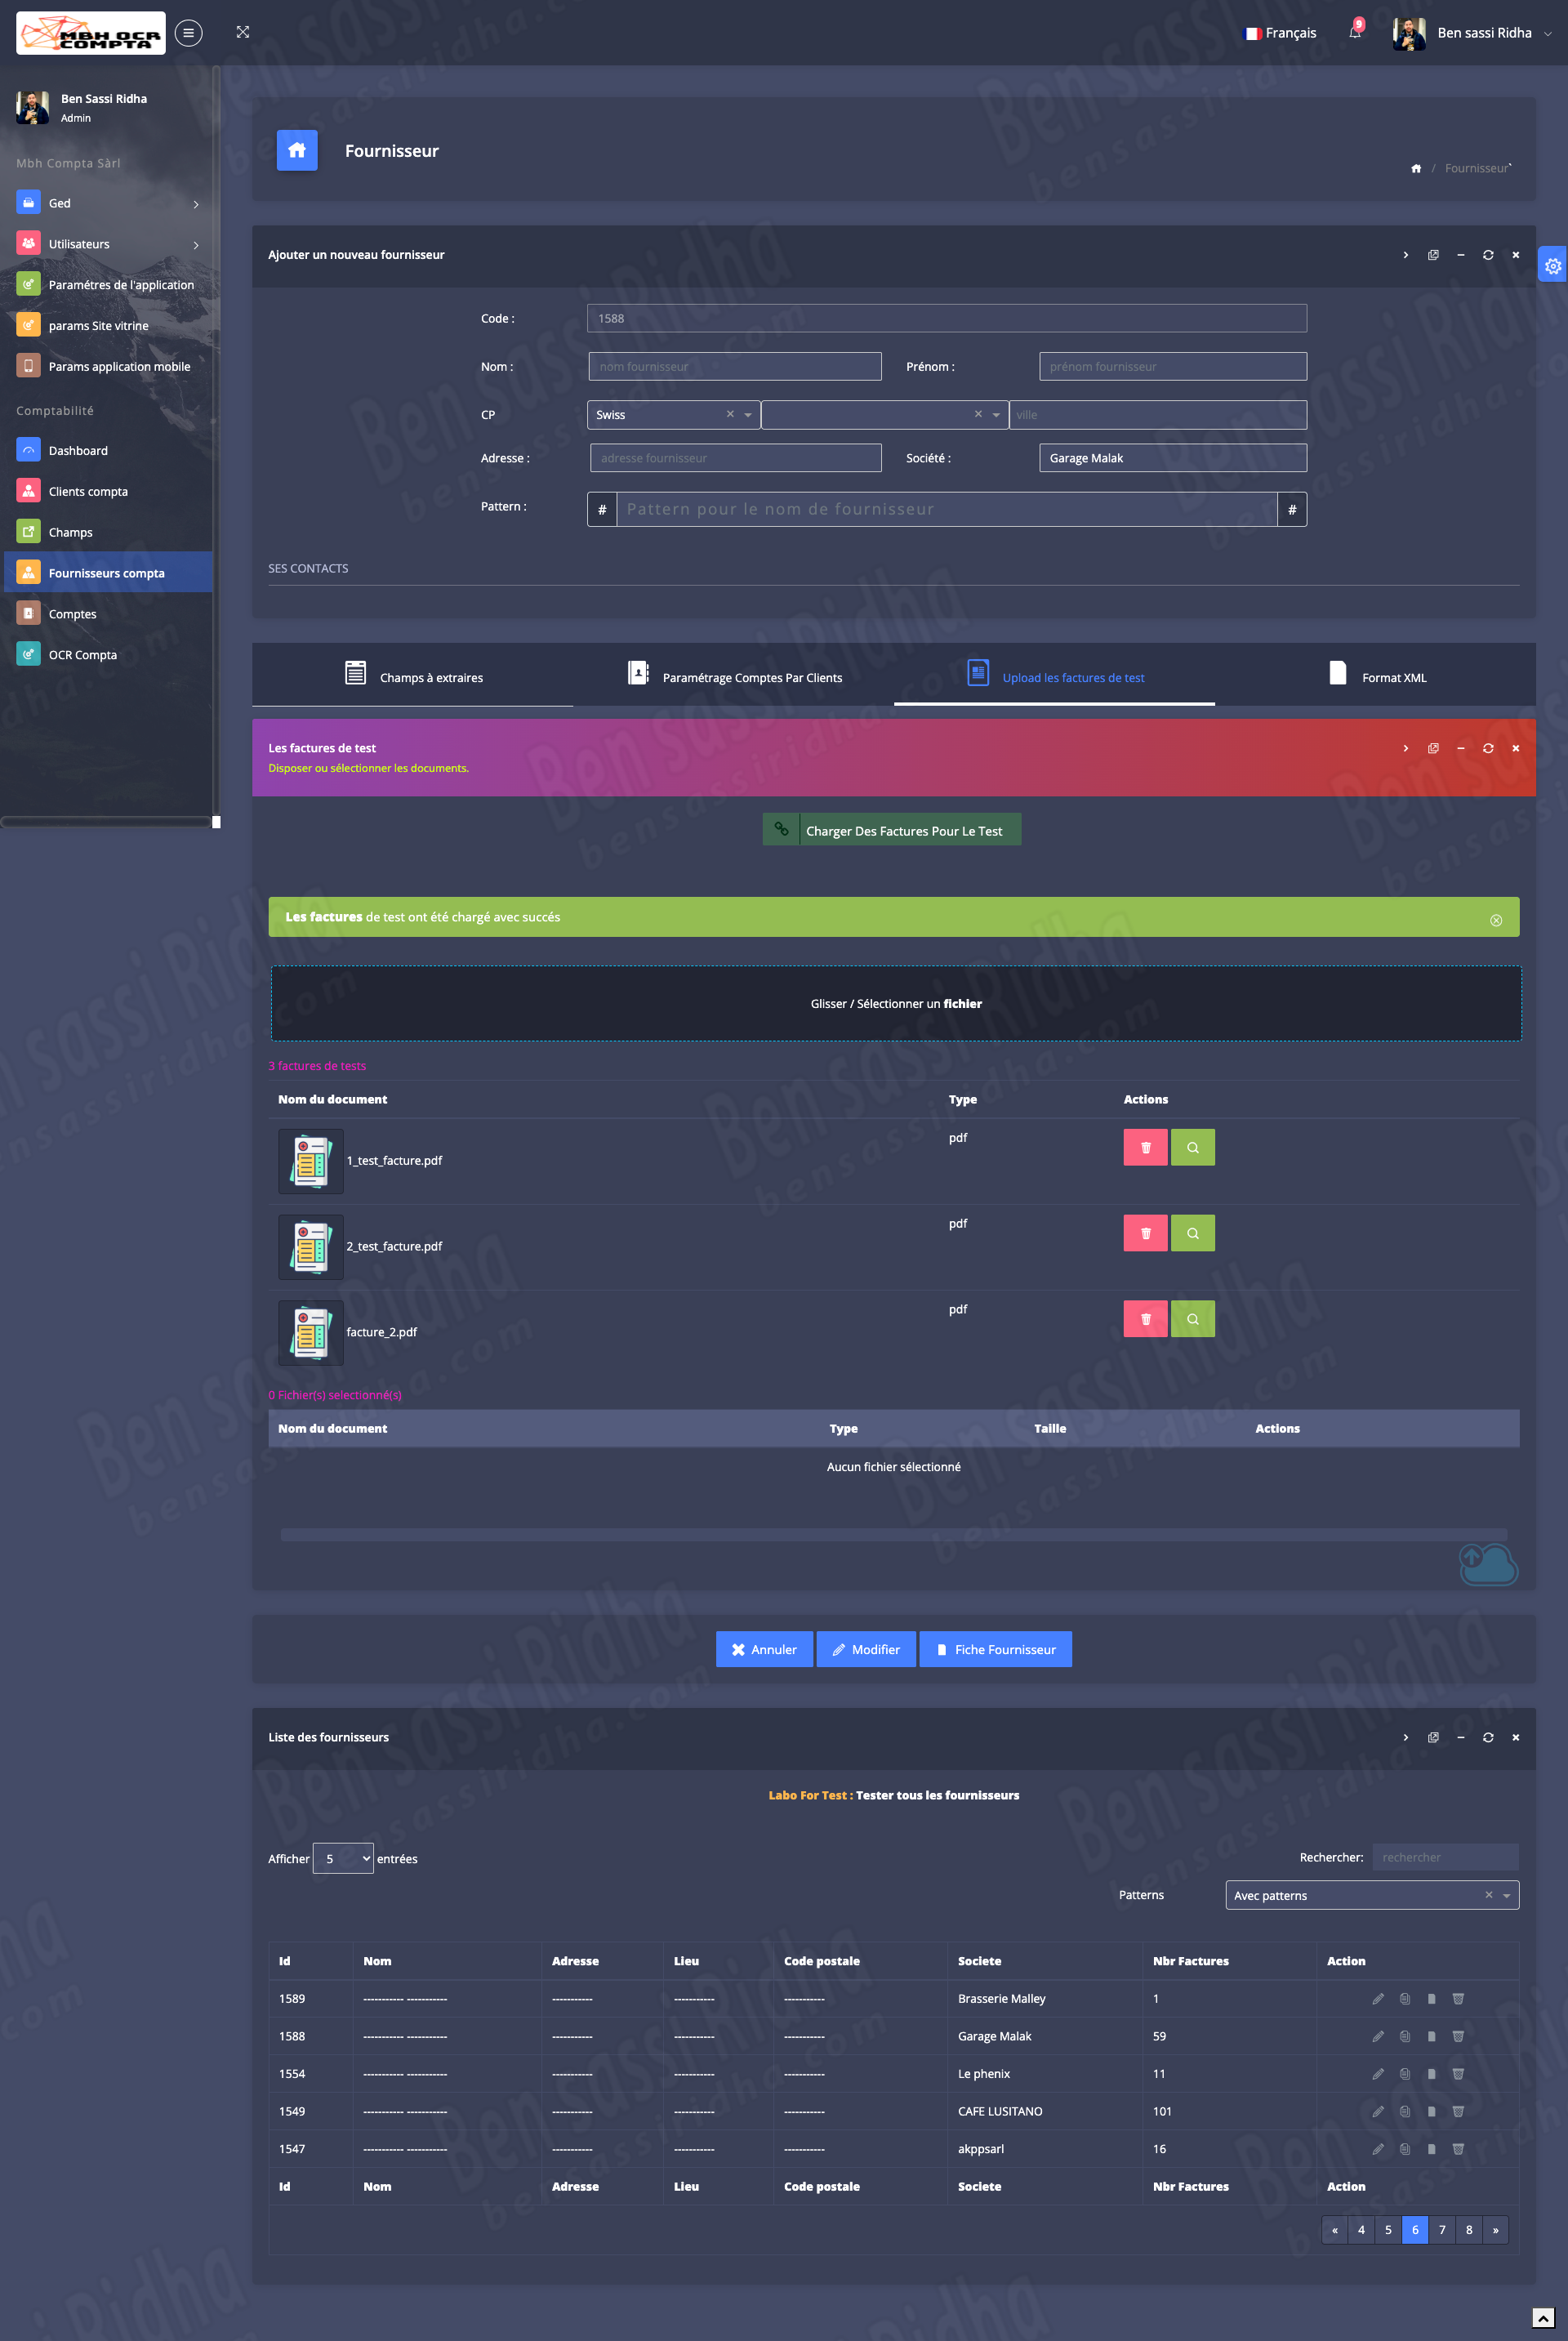
- Gérer les fournisseurs
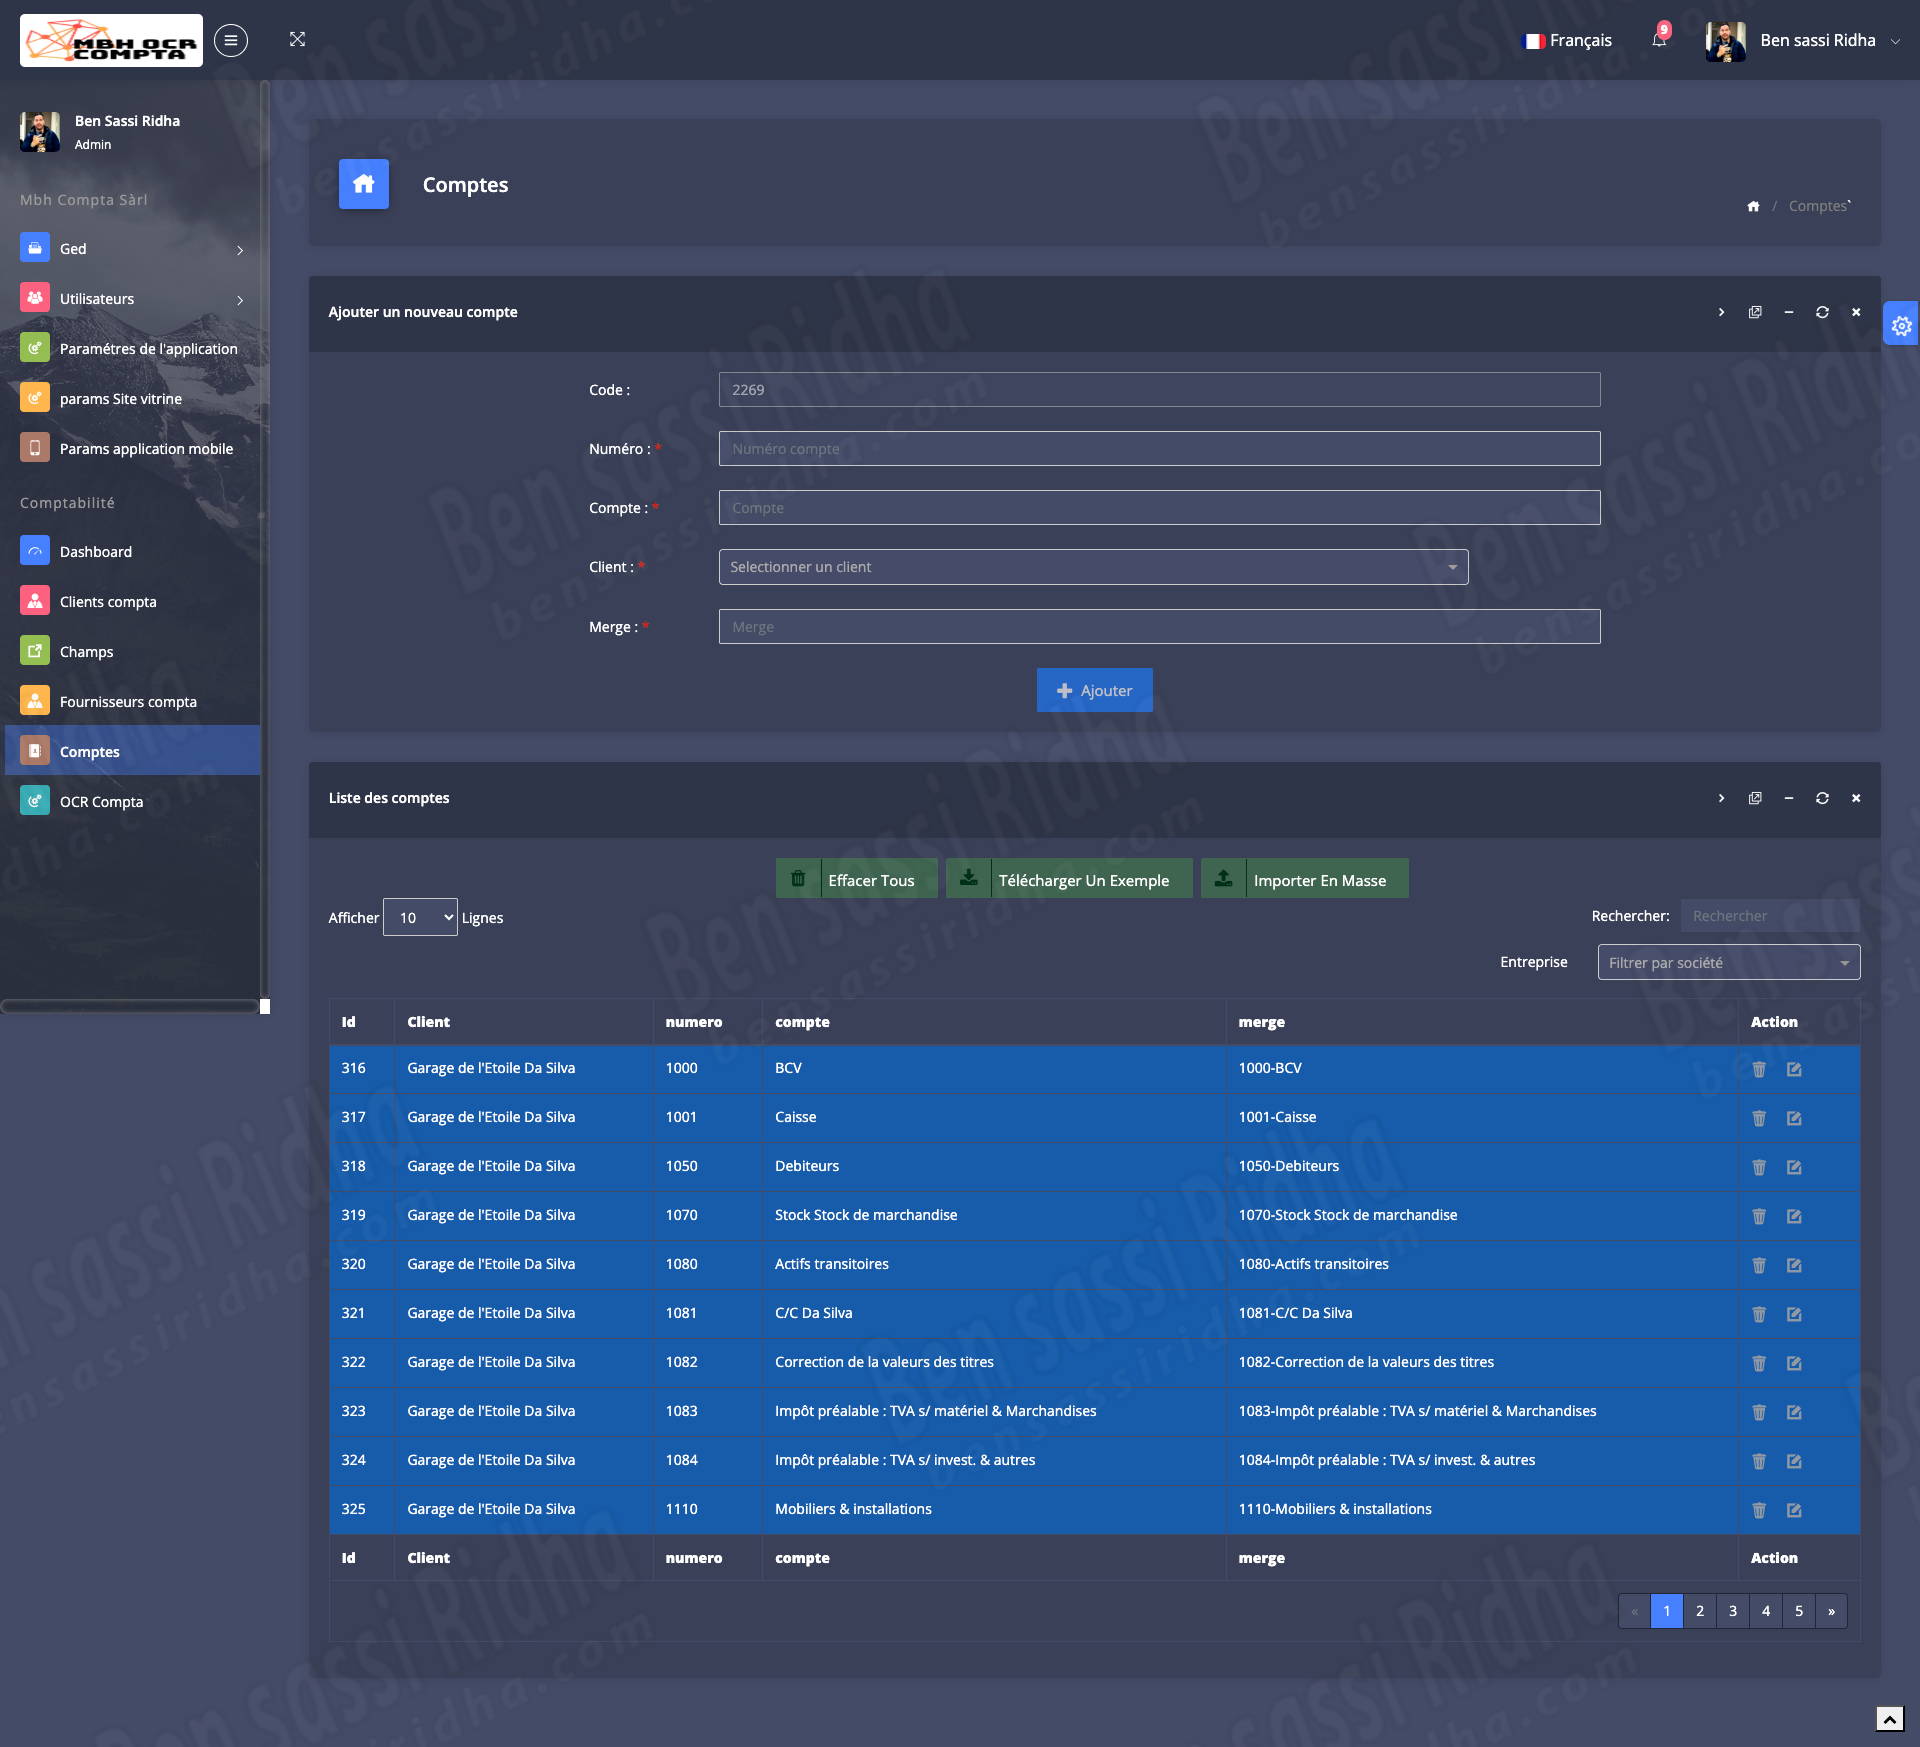
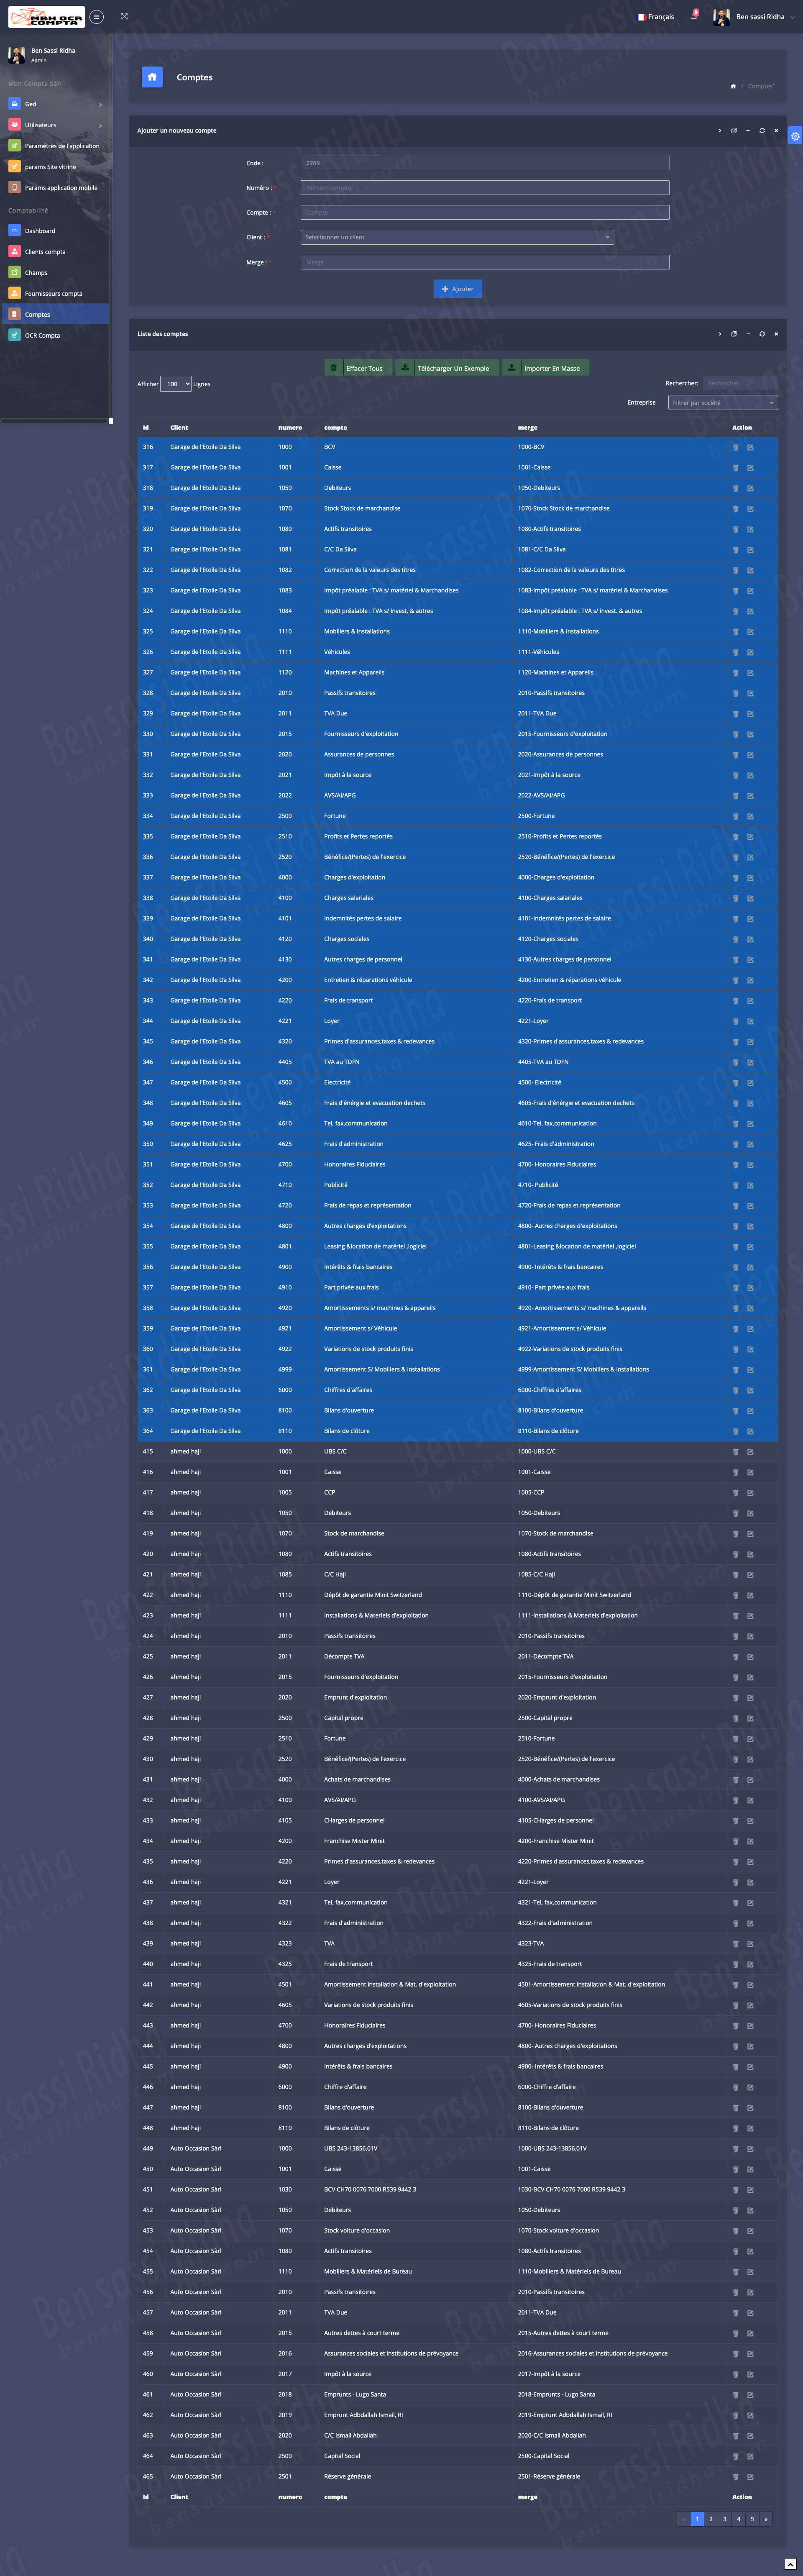
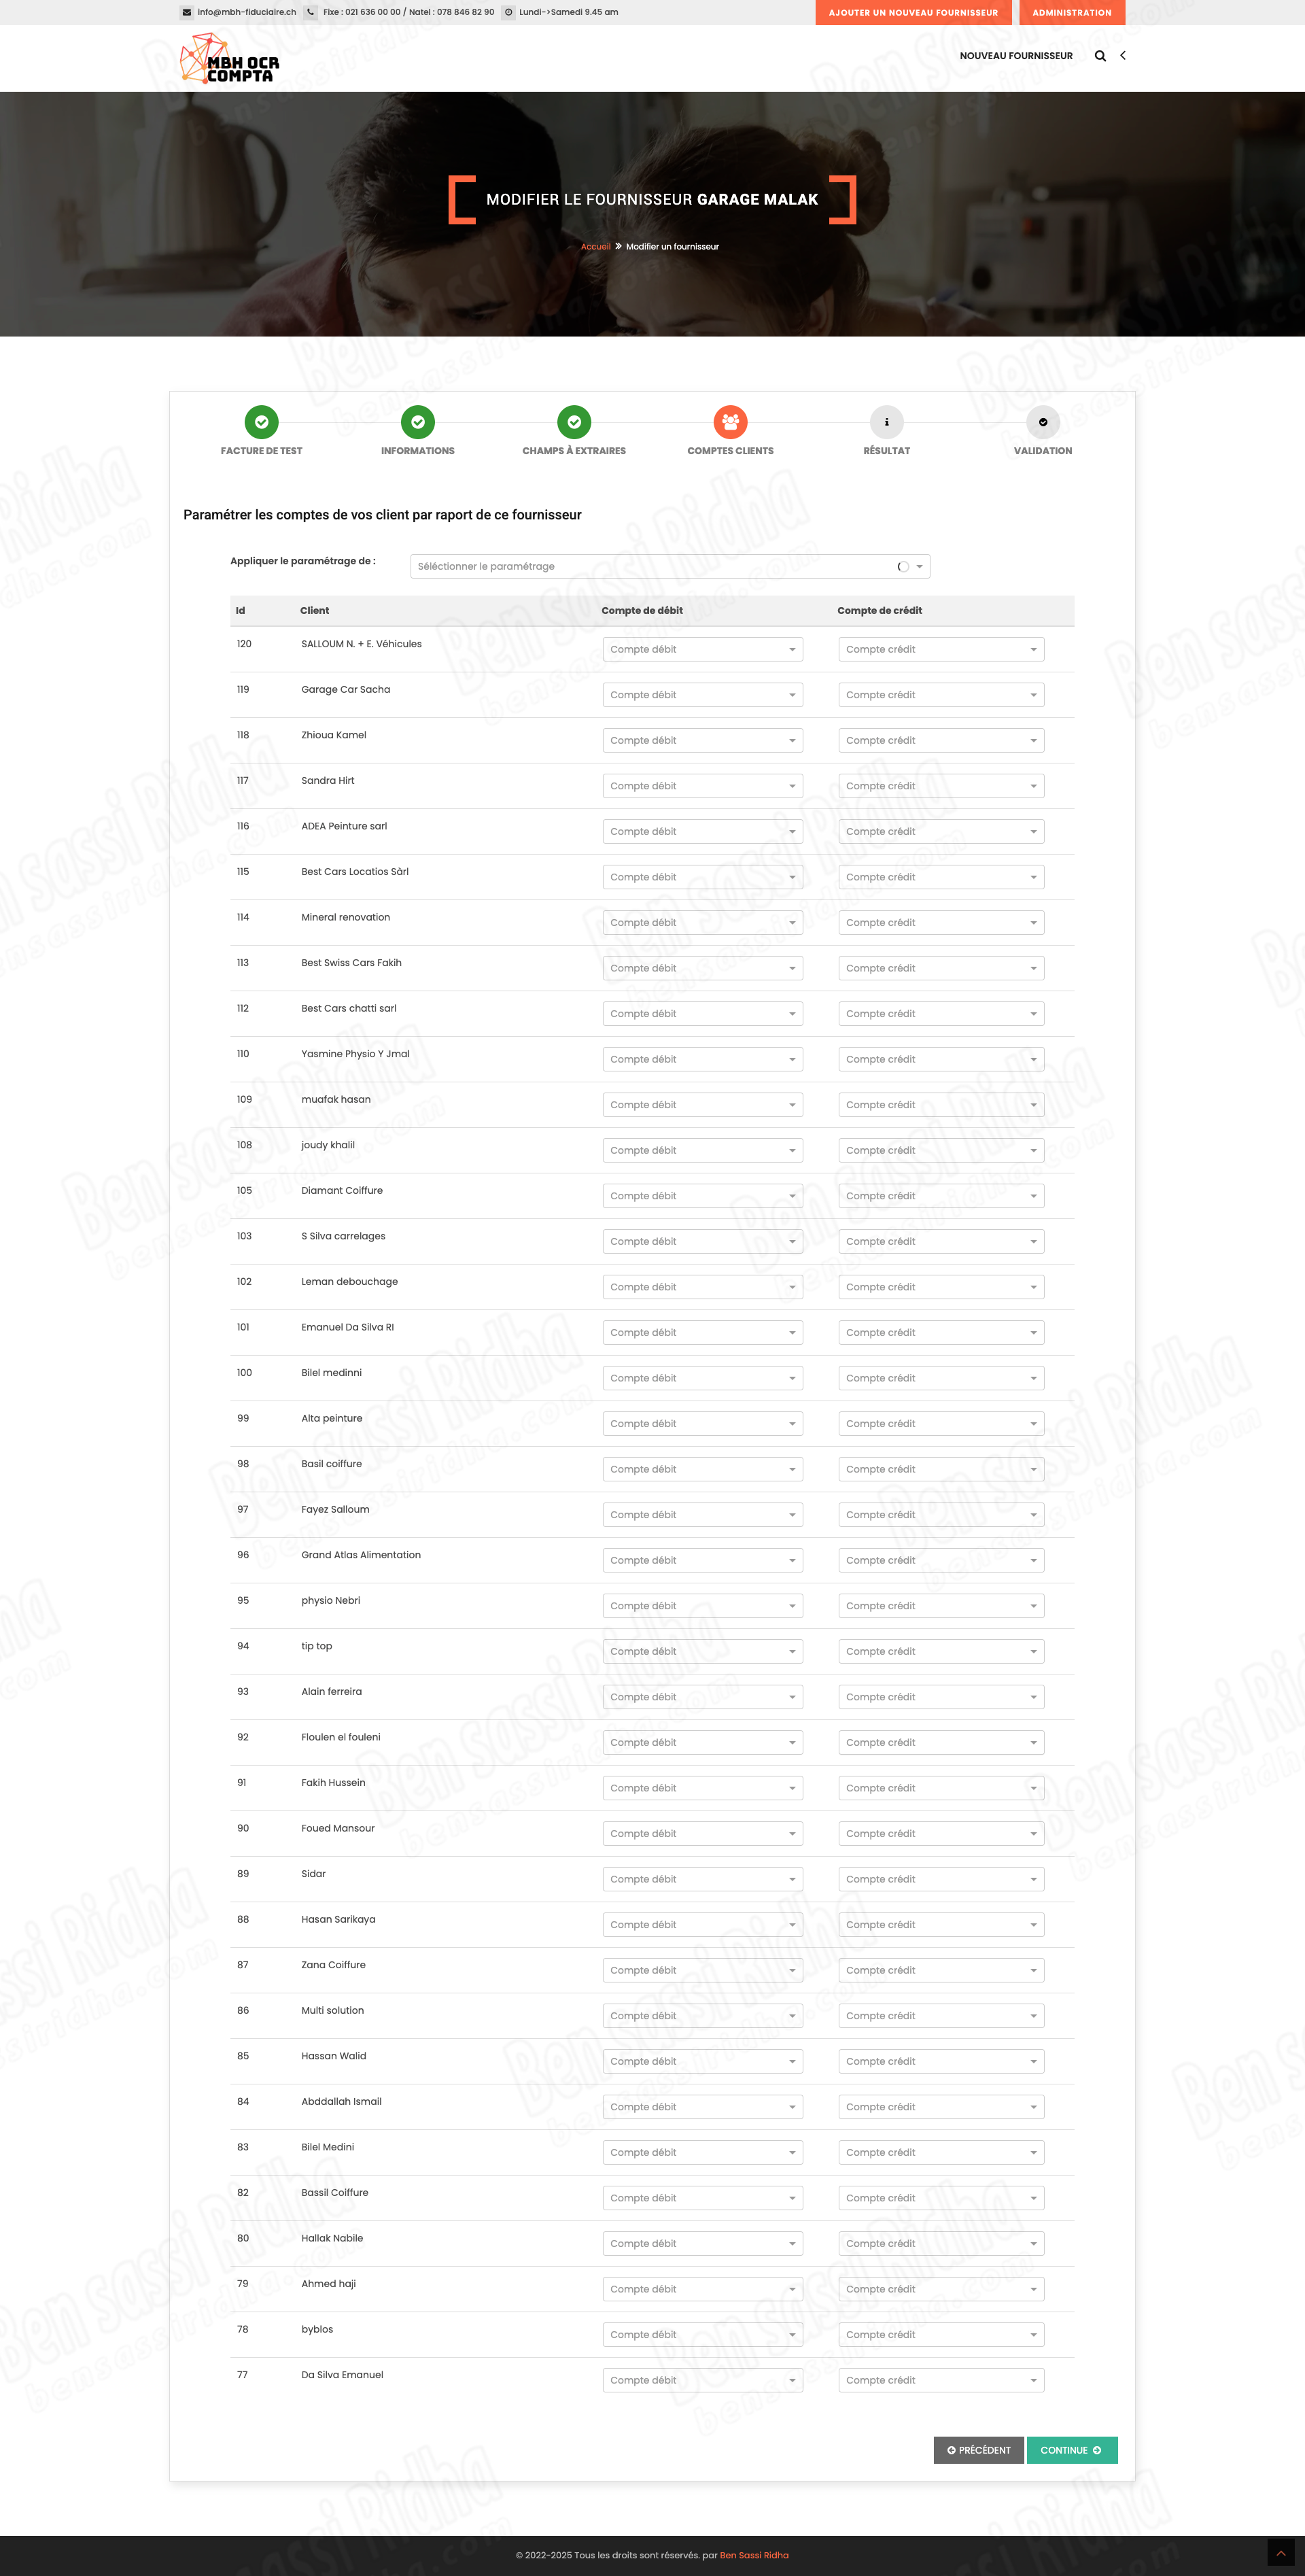
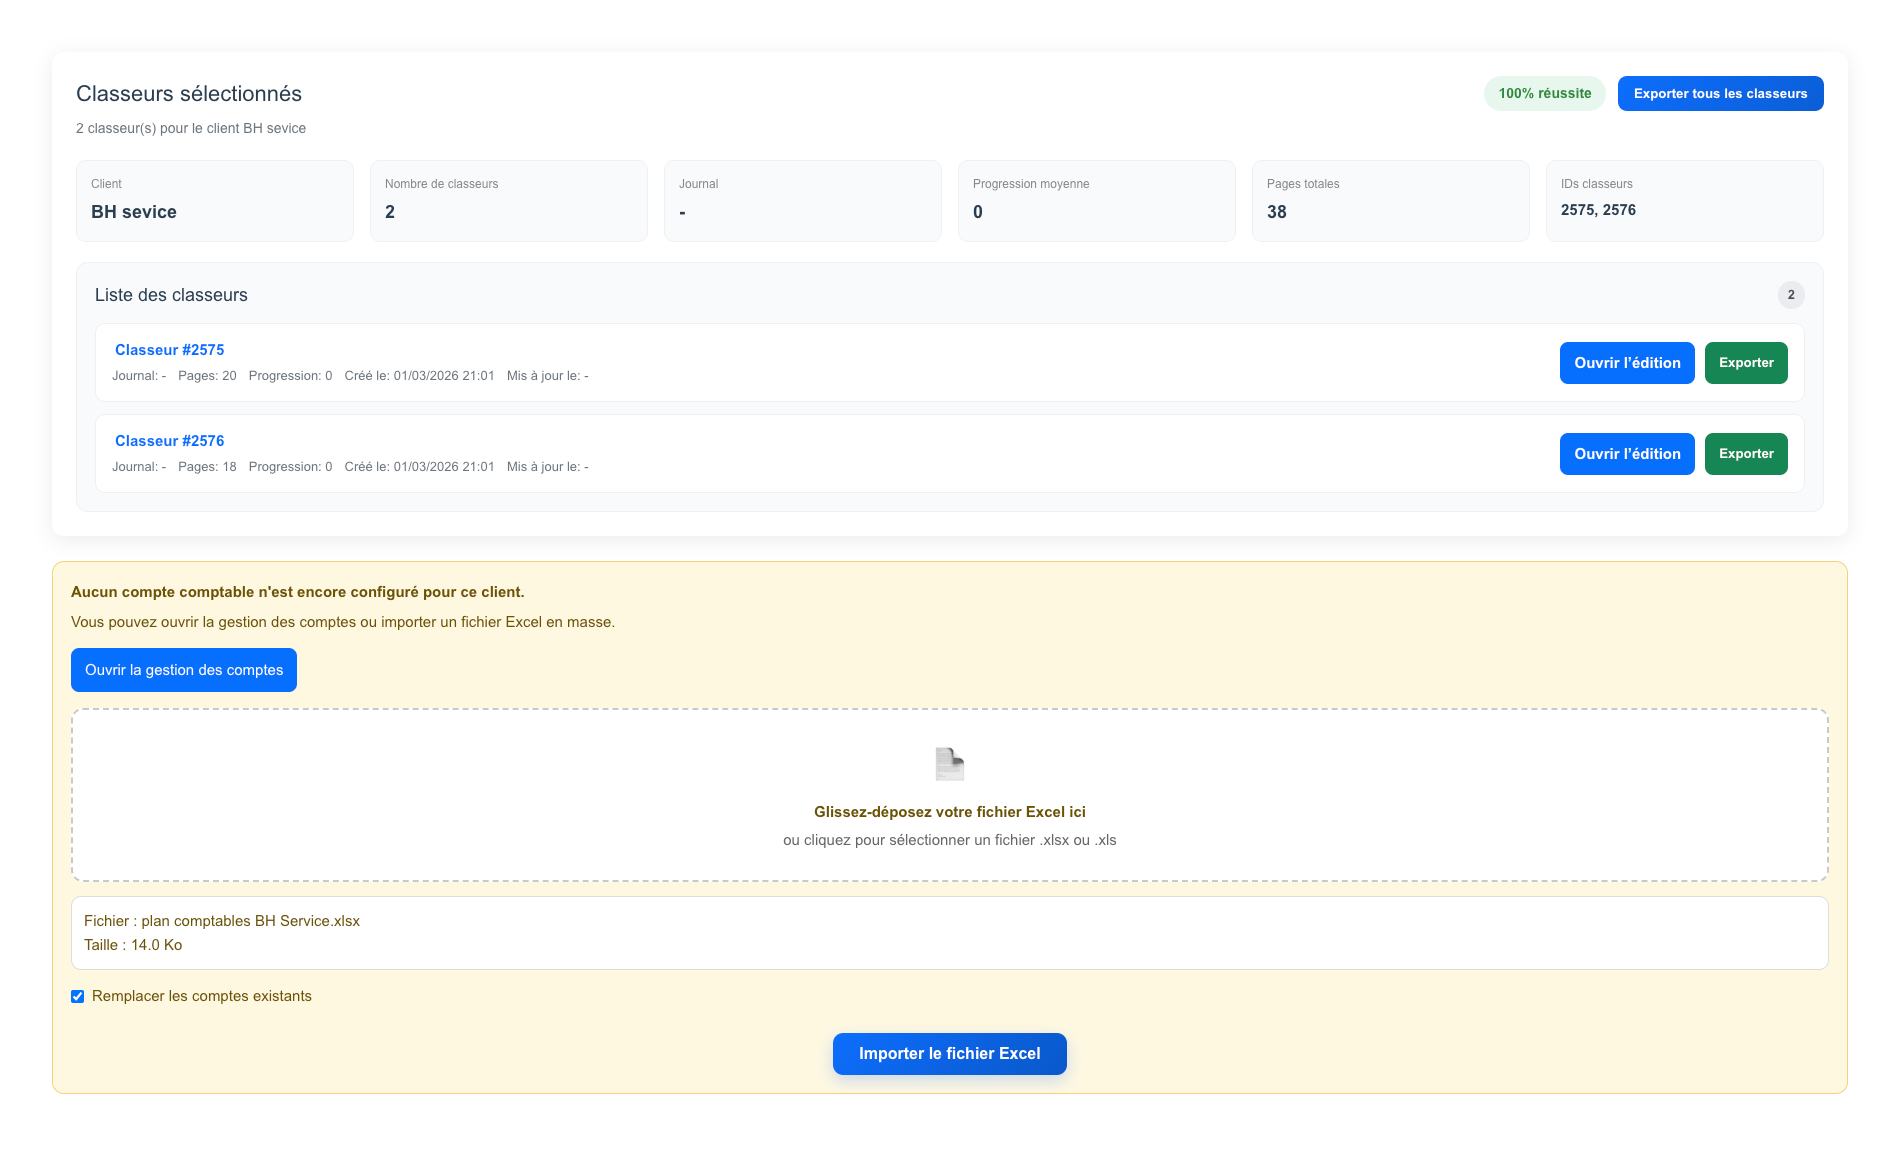
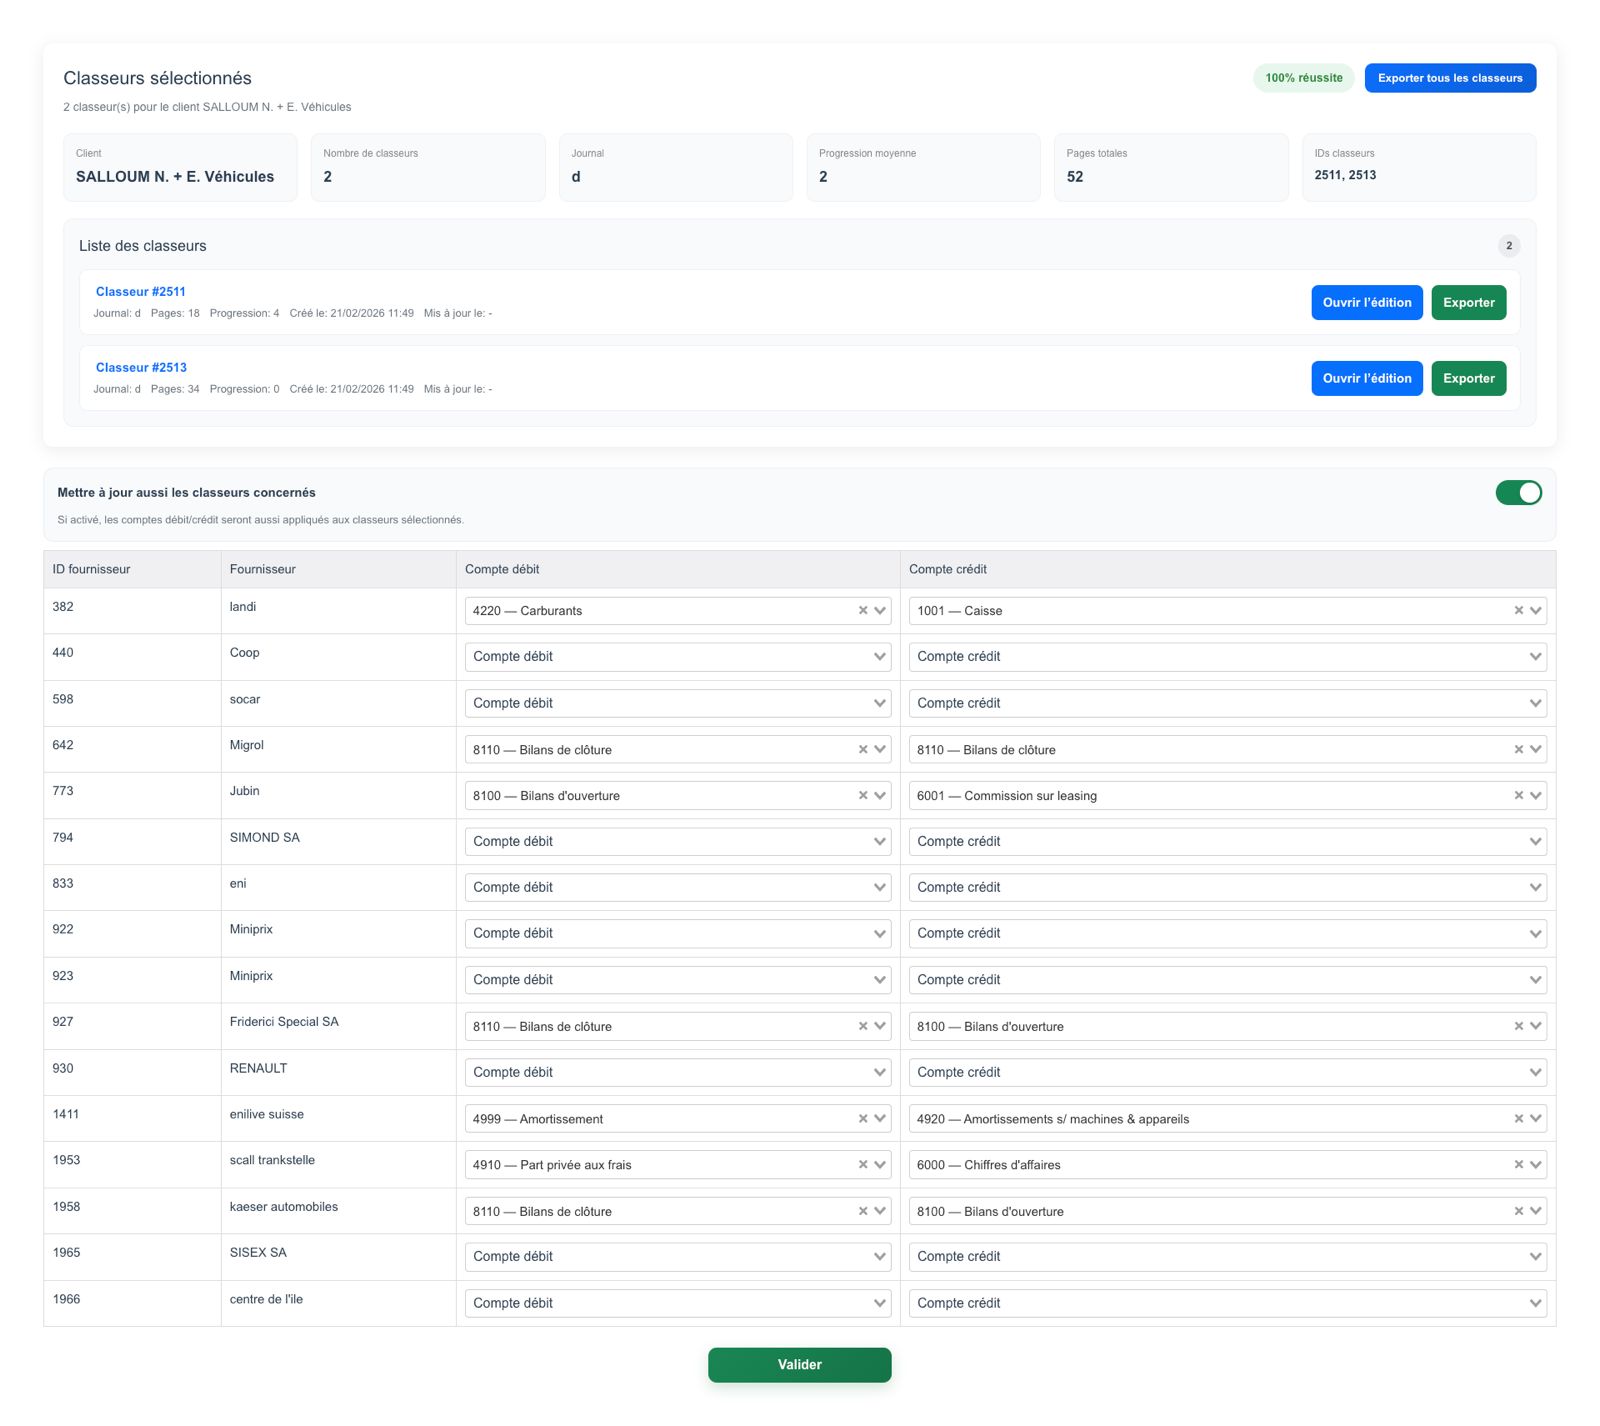
- Gestion de la comptabilité des comptes pour chaque client
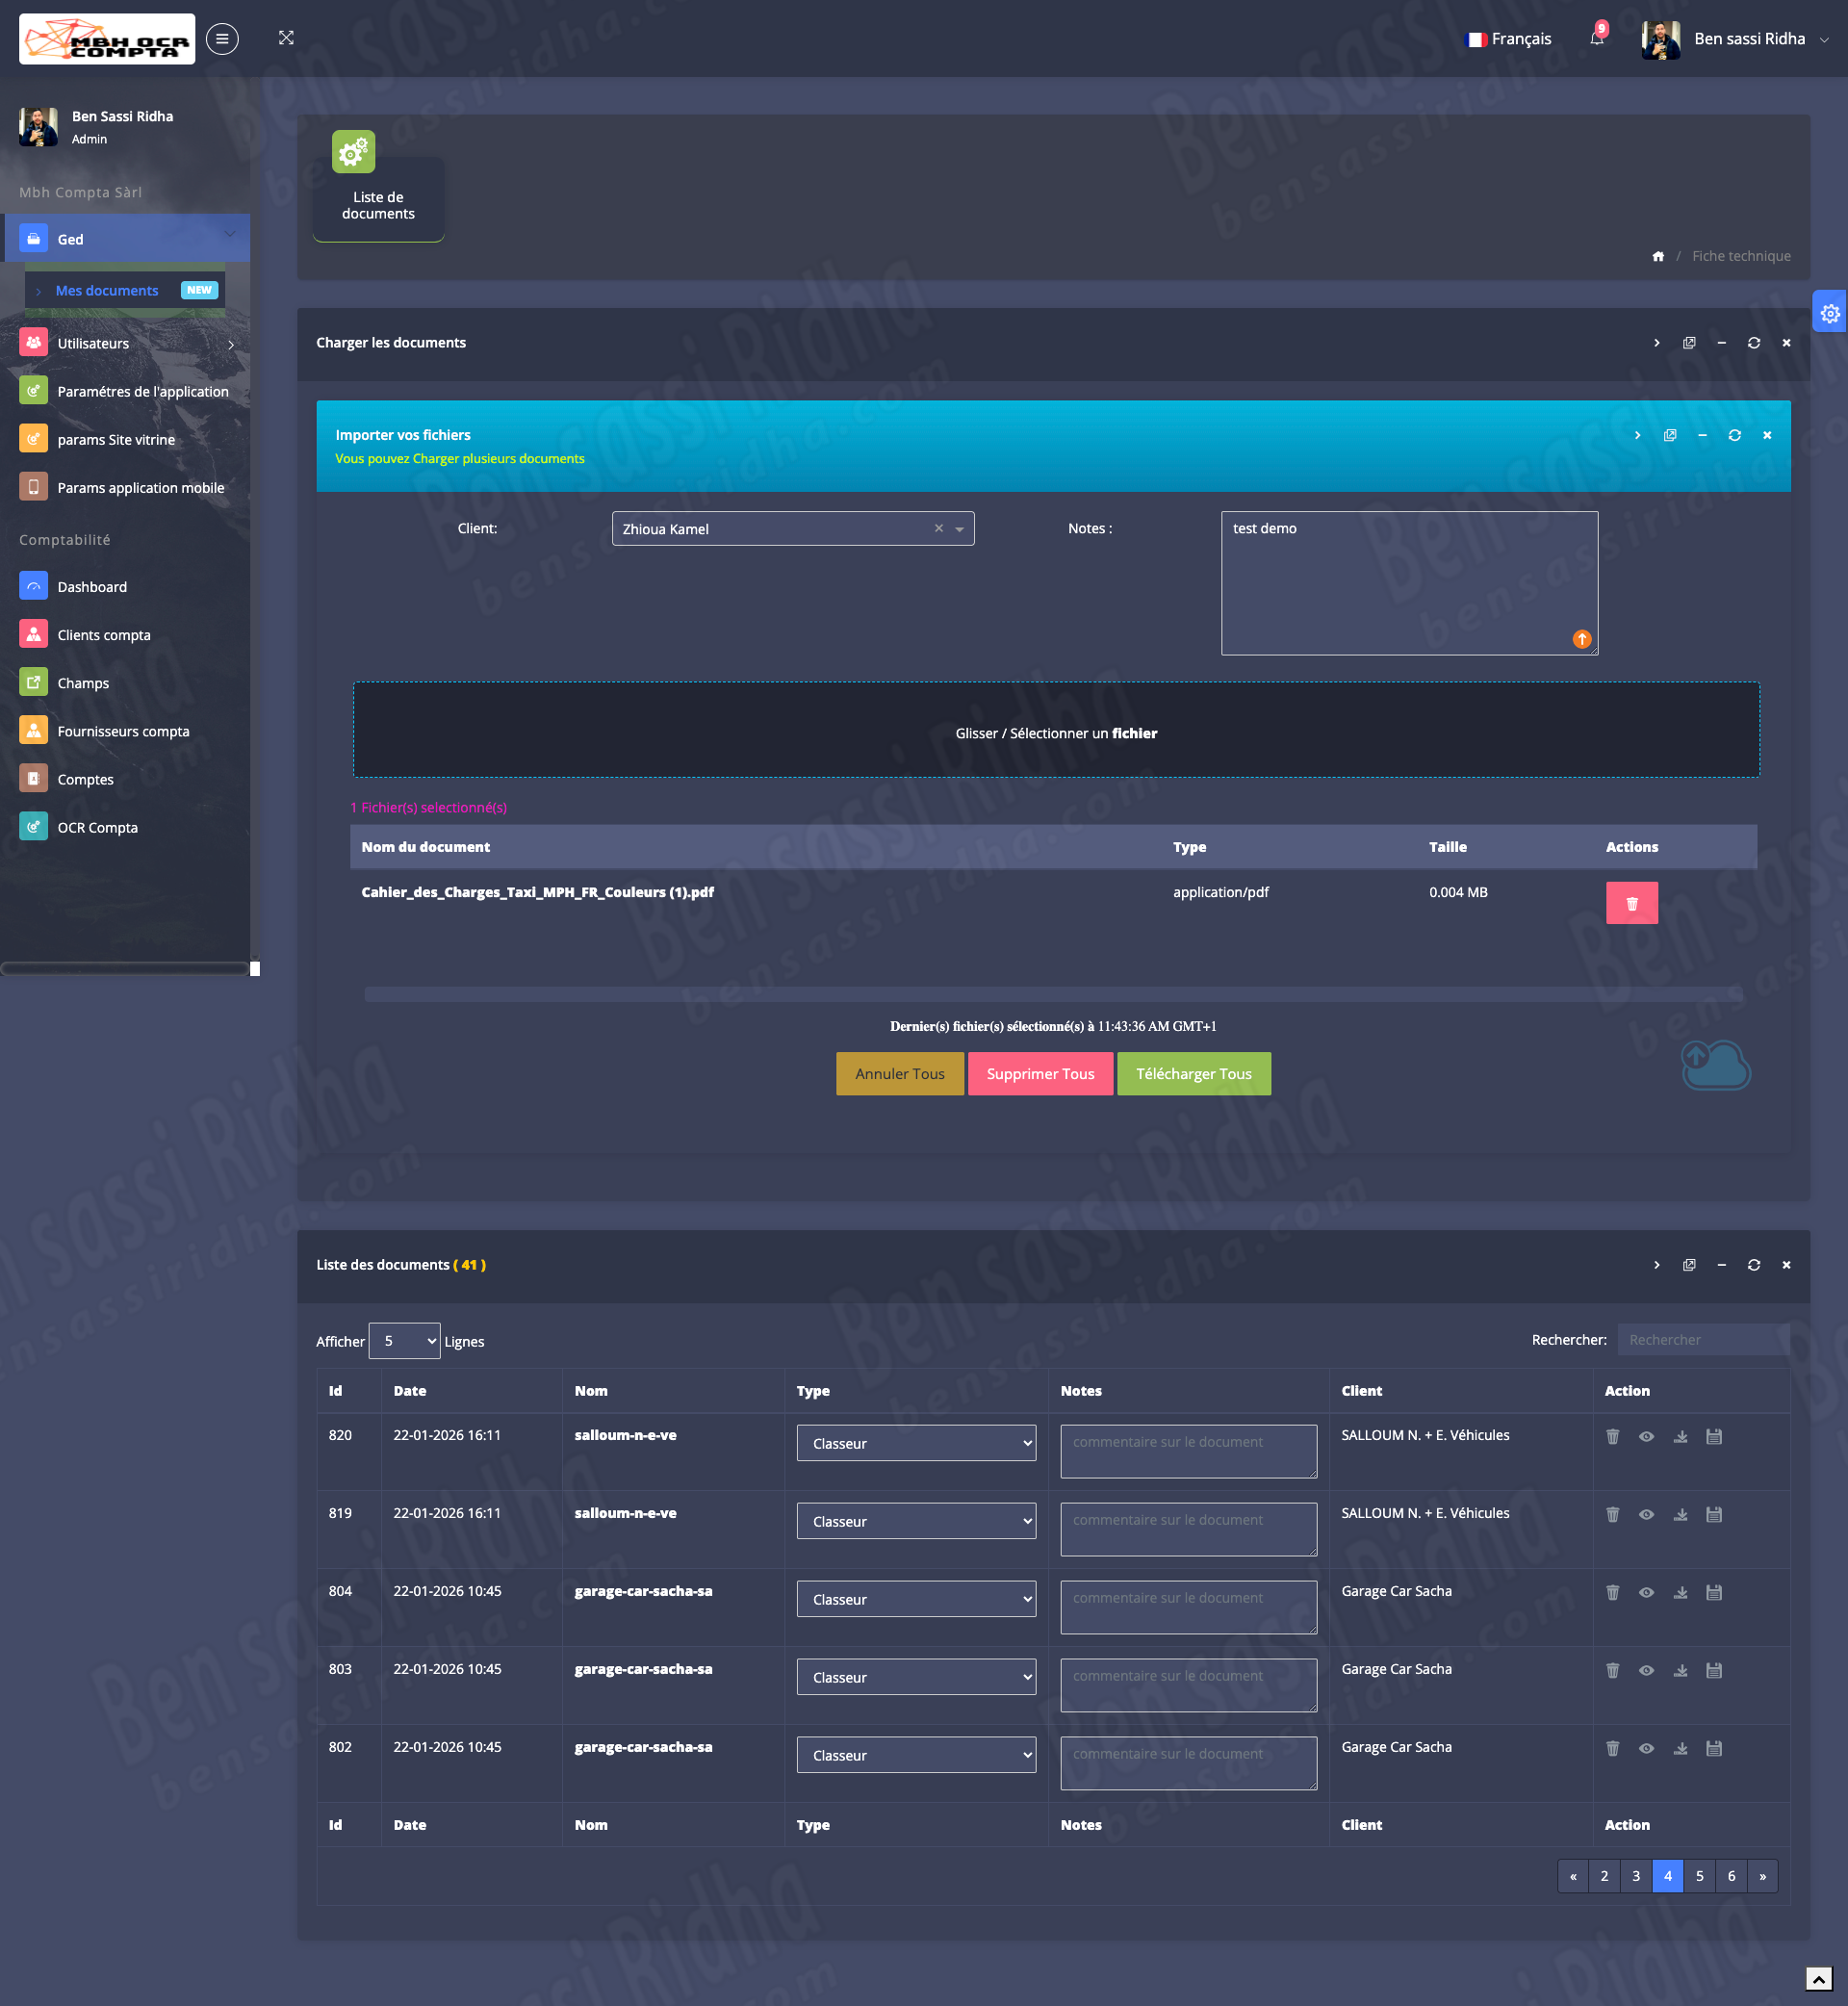
- Consultez la liste des factures numérisées et de leurs champs qui ont été extraites
- Exporter le résultat de l'OCR vers un fichier Excel
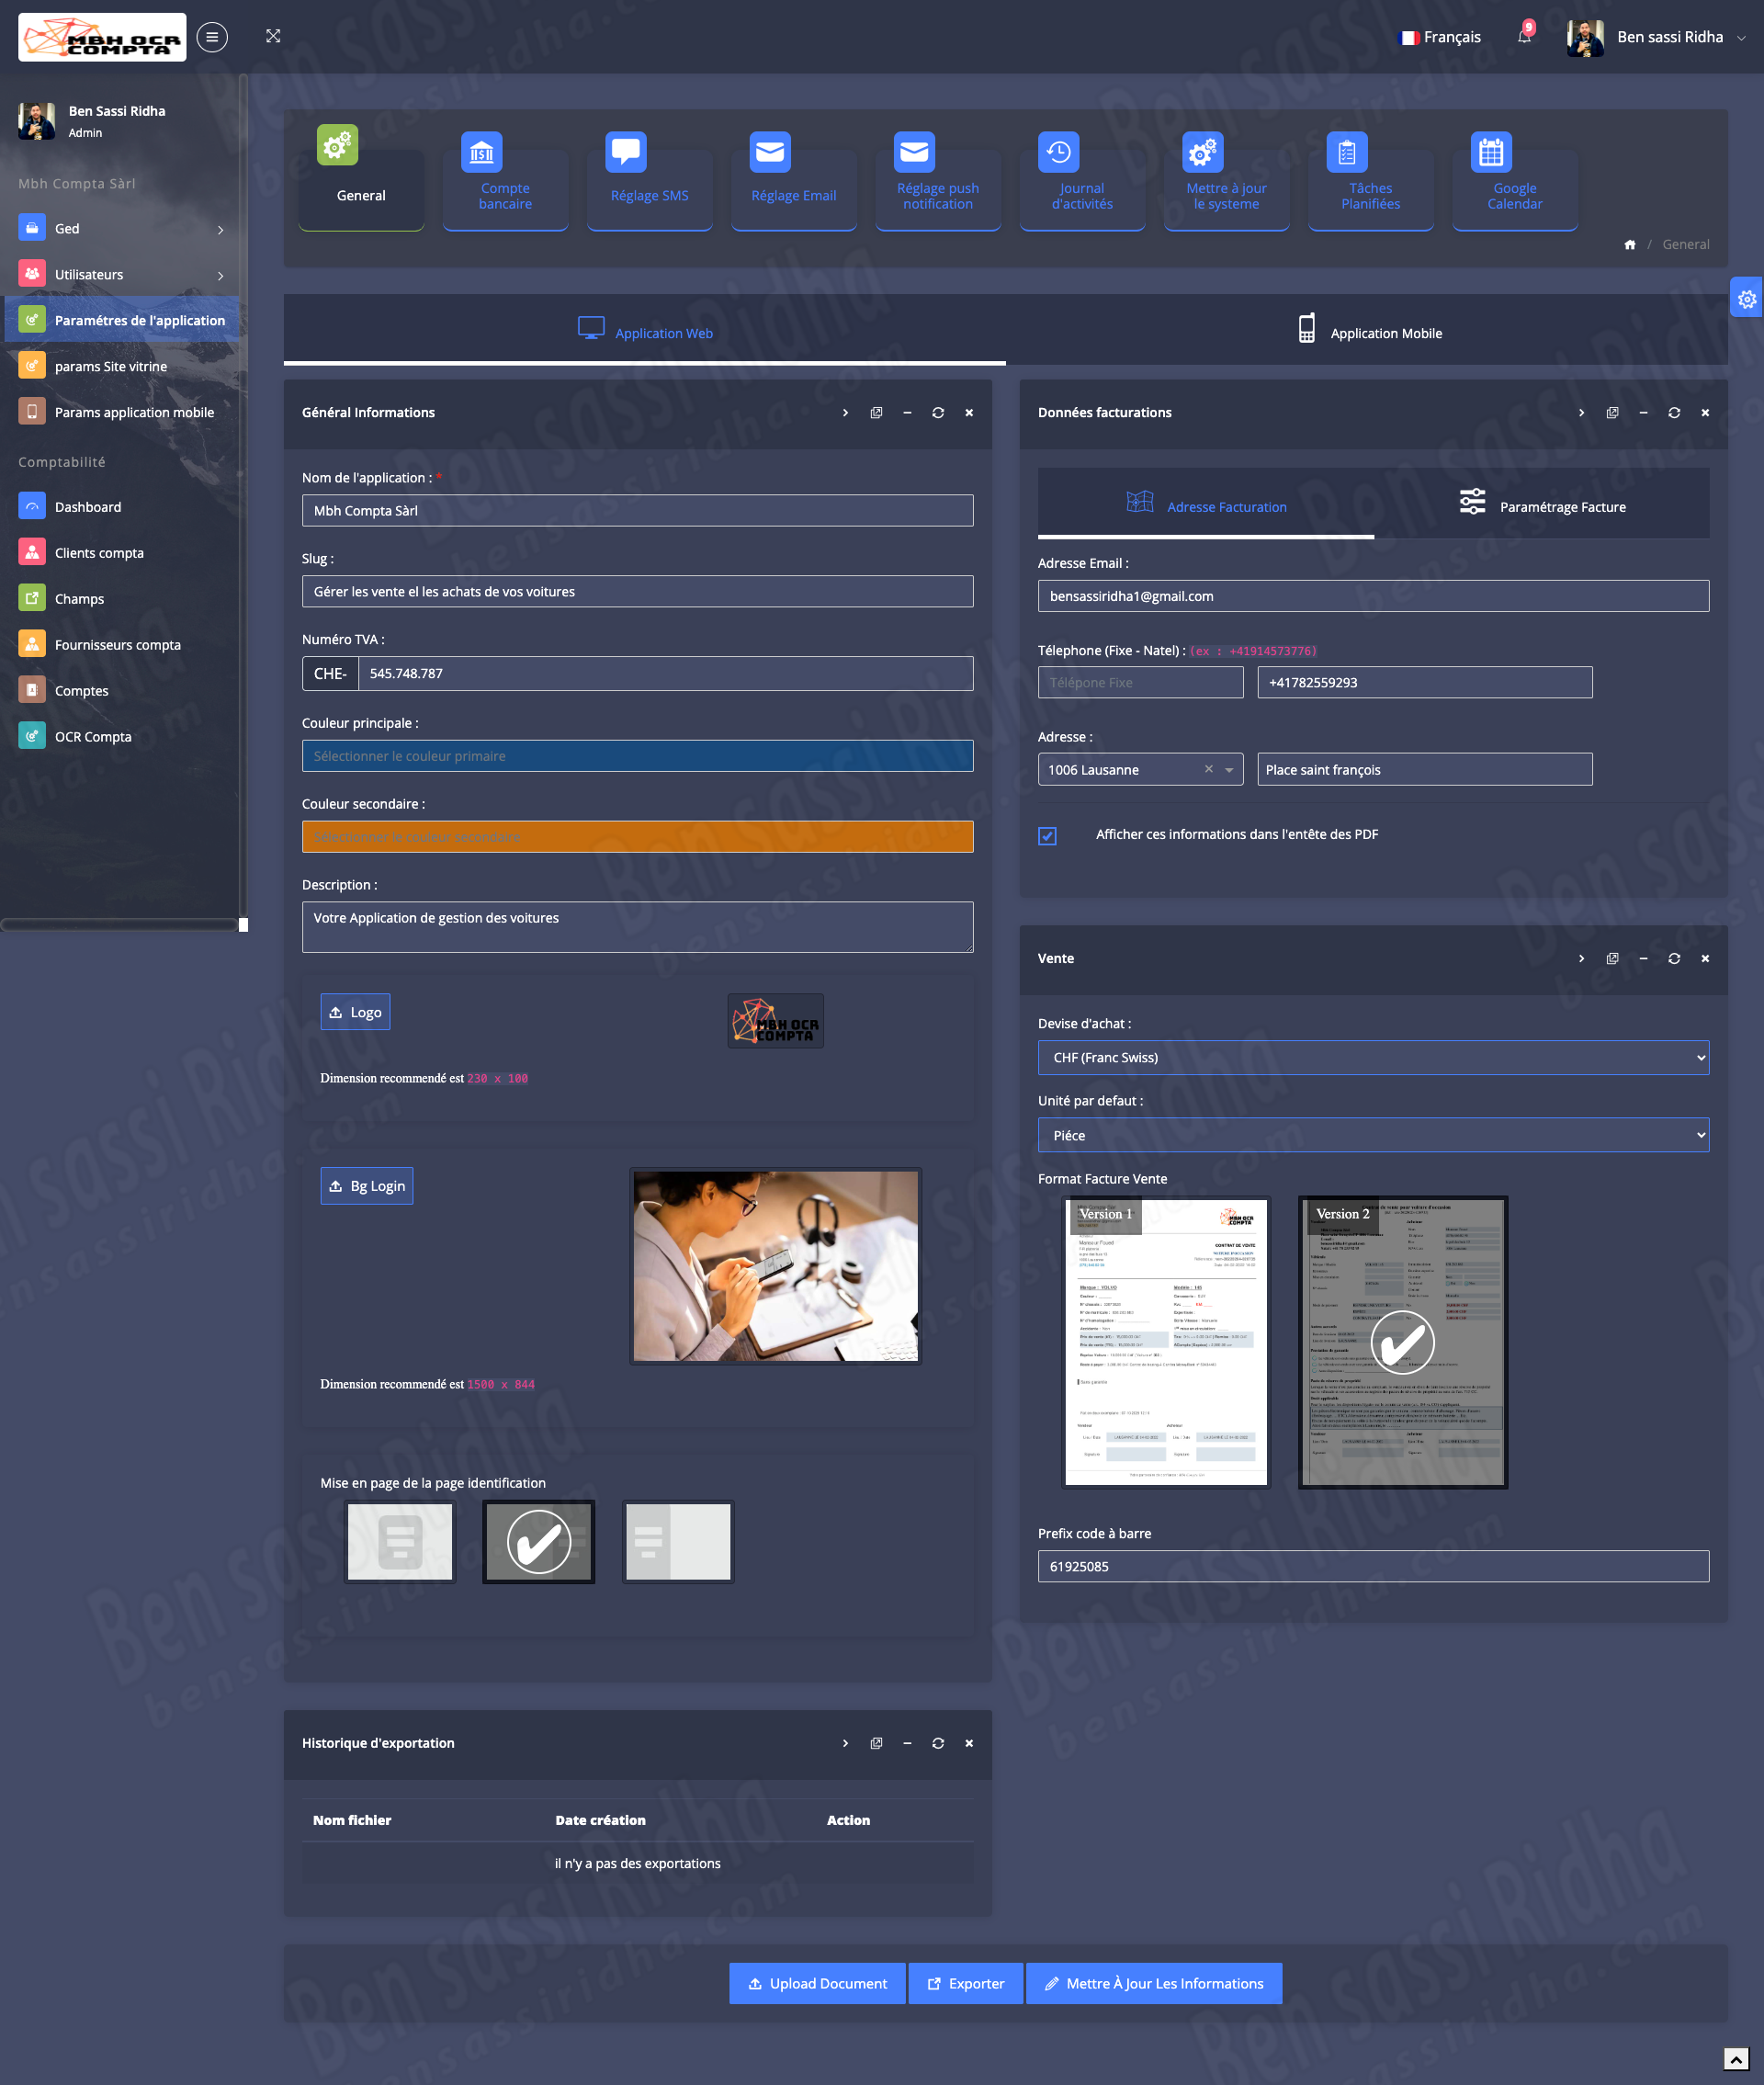
- Gérer les paramètres de l'application (les rôles, les autorisations des utilisateurs, l'historique de l'activité)
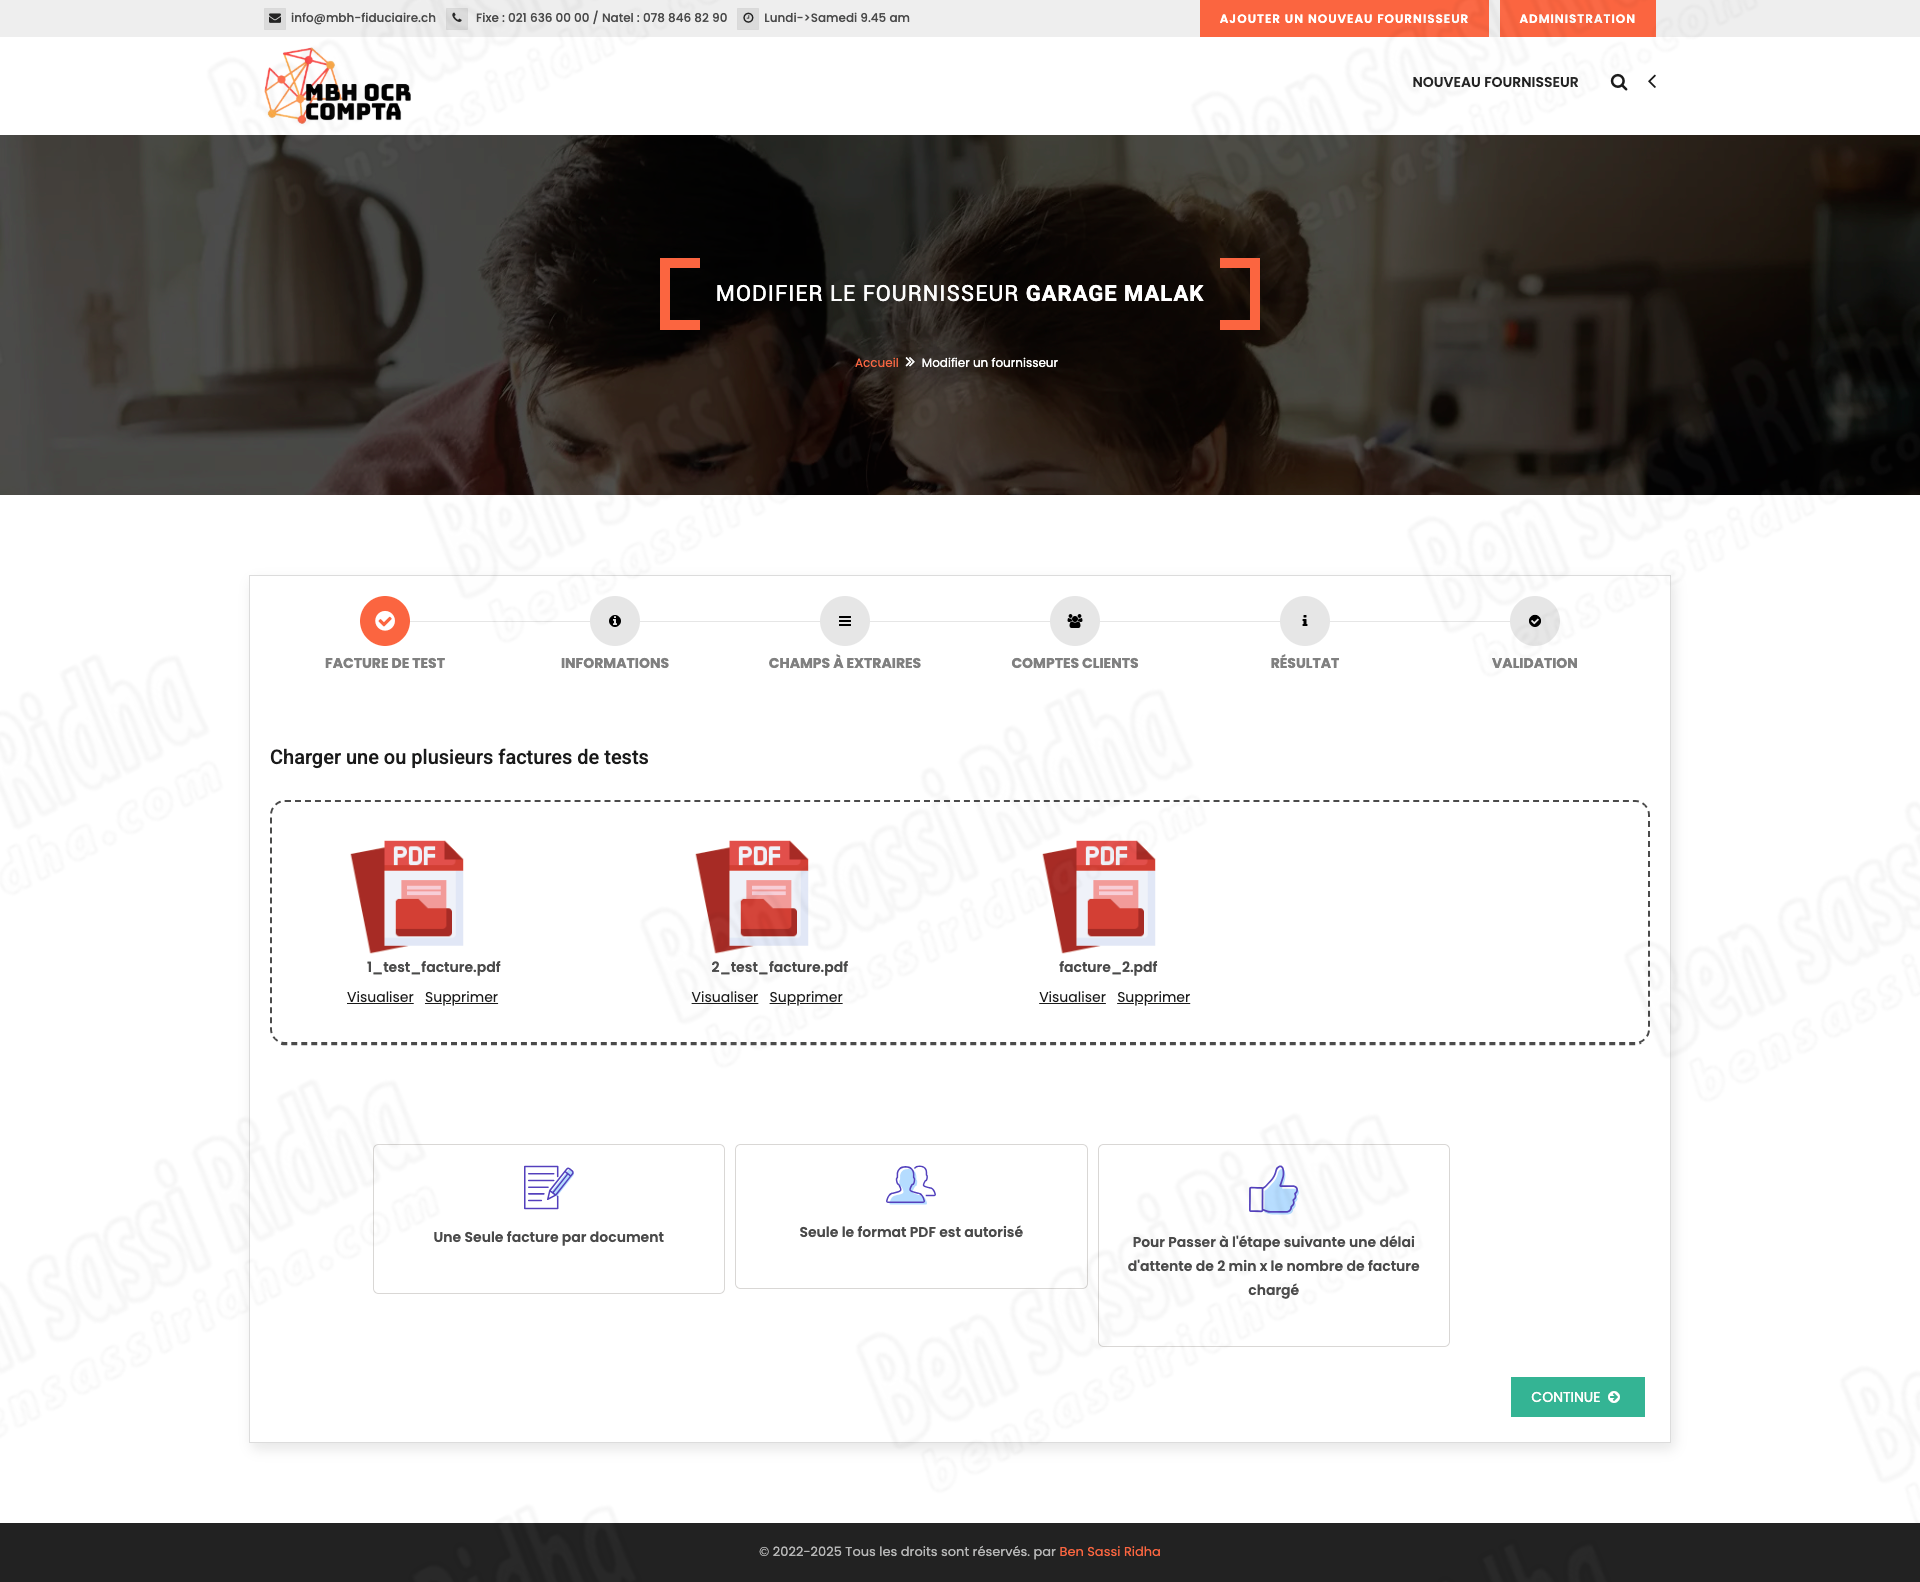
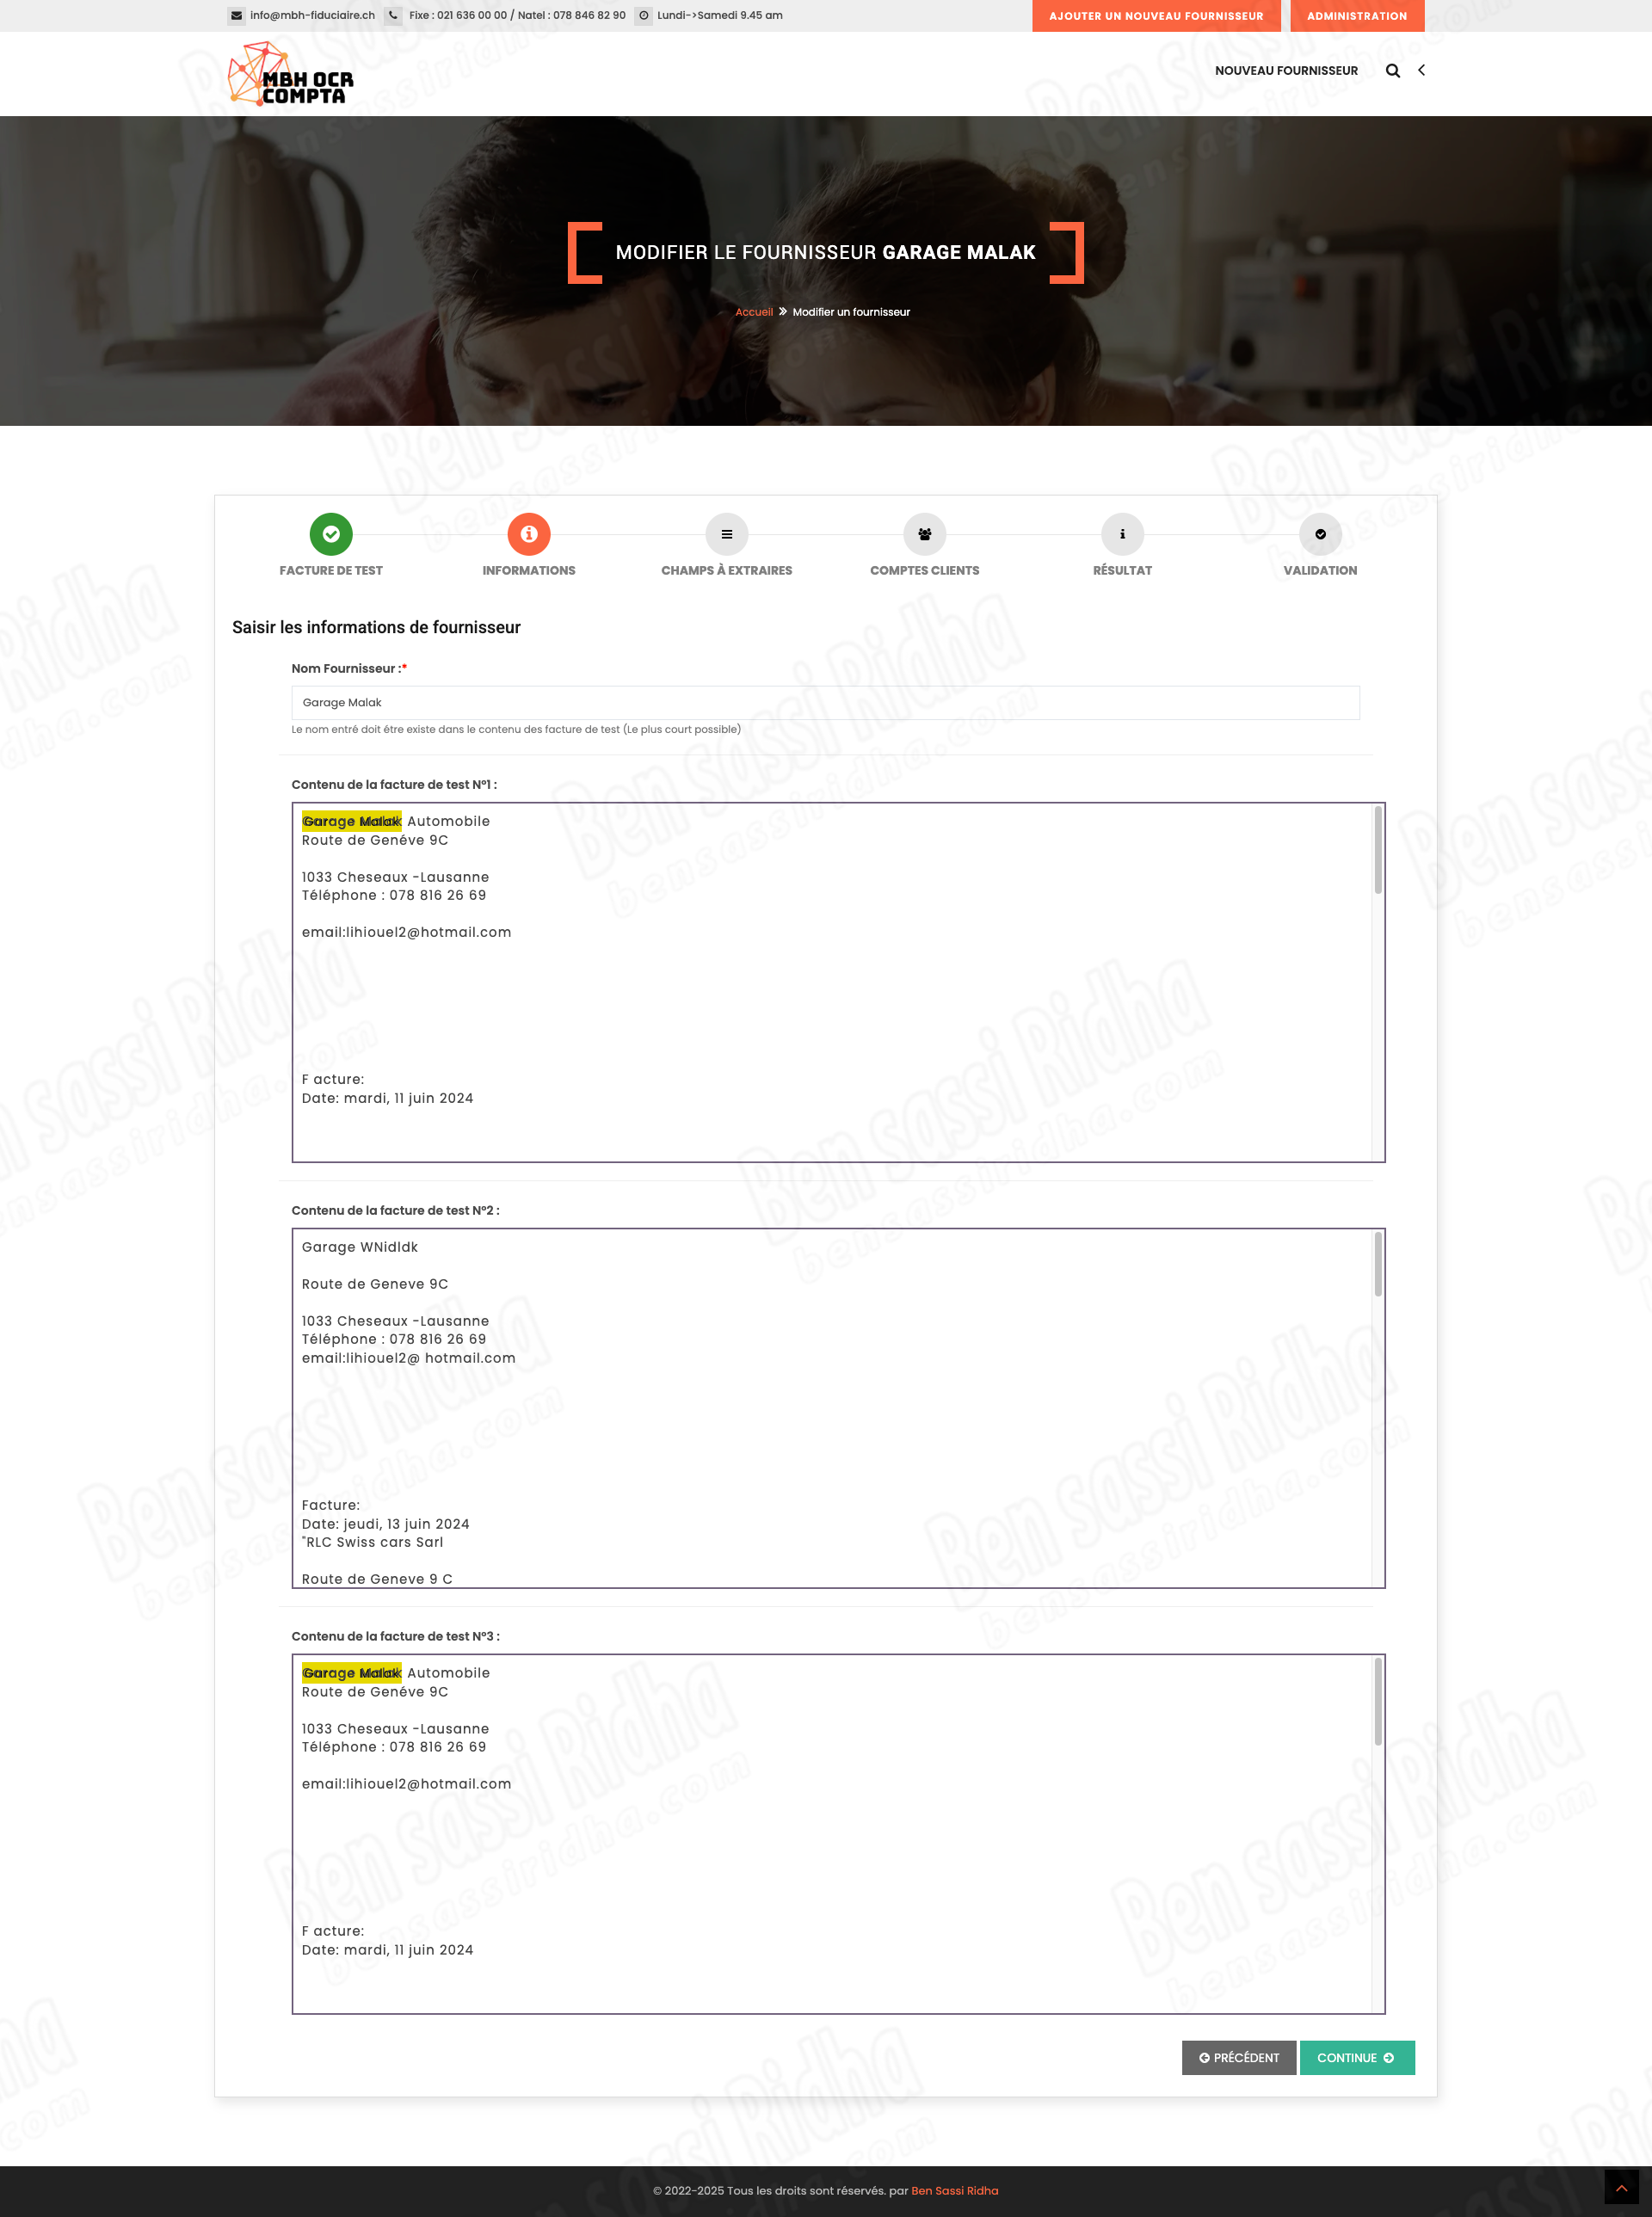
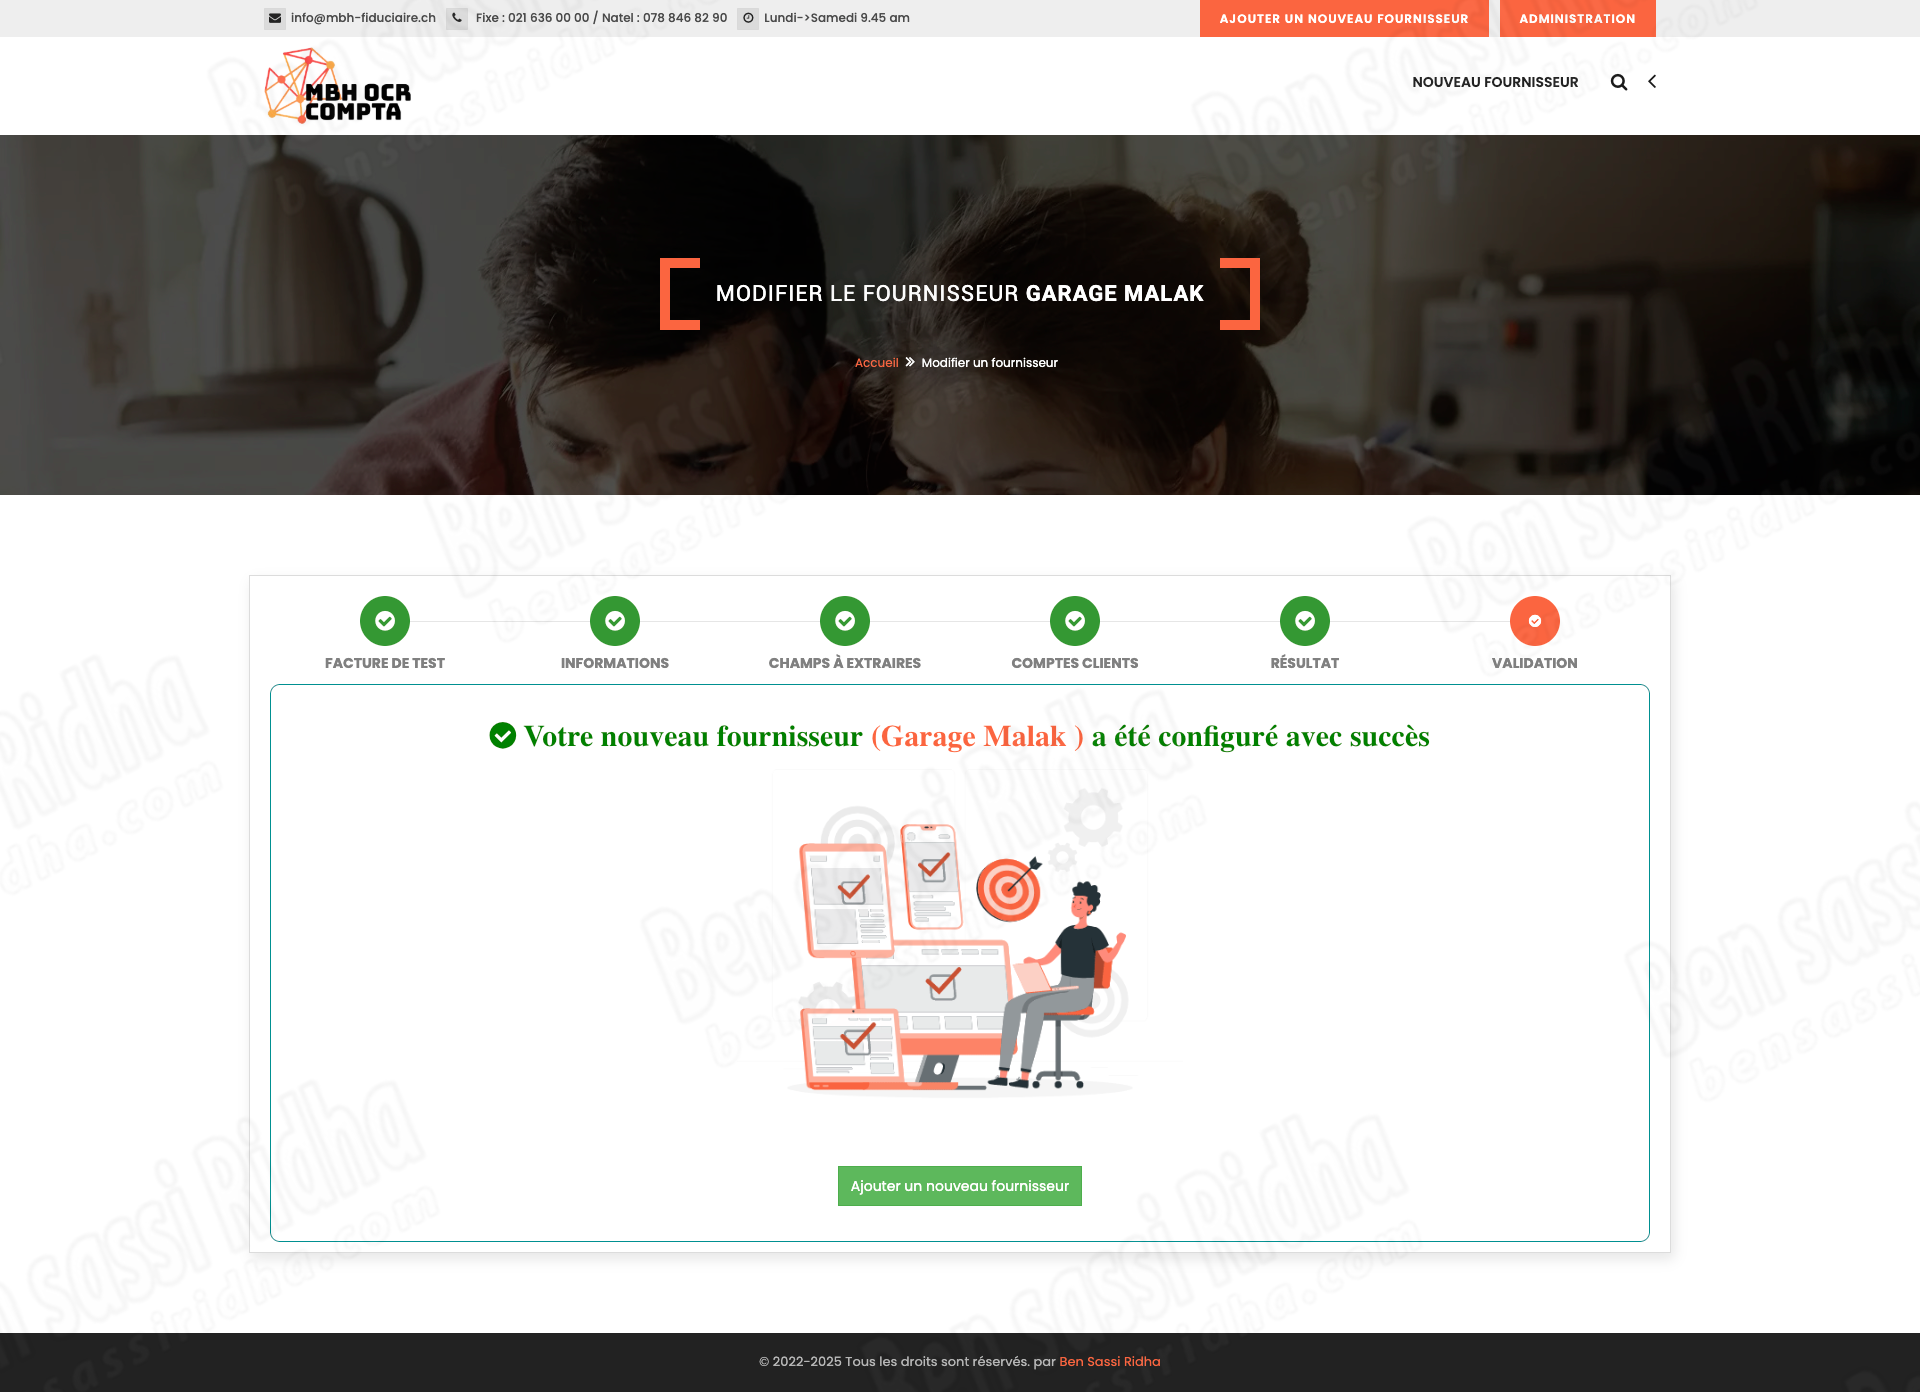
- Facilement ajouter un nouveau fournisseur à l'aide d'une interface appelée "Test Lab"
- Frontend partie pour faciliter l'ajout d'un nouveau fournisseur de modèle les factures ainsi que de définir les tendances de chaque champ à extraire
Les clients
Cette solution a été vendus à plusieurs clients en Tunisie, en Suisse et en France

Les Points sur les technologies de l'
This project is composed of two parts, FrontEnd part developed by Angular 8 , VueJS 3.0 and a BackOffice part developed by Laravel 7. Communication between these two parts is ensured by web services
Pré Demande d'installer les Outils en OS
- Tesseract ocr 6
- ImageMagick
- Ghost Script
- LibTiff
Les Packages utilisés sur le côté Angulaire
- Jselect
- JCalendar
- ngBootstrap
- ngx DataTable
- FullCalendar
- ngSnotify
- ngLightBox
- Moment
- Lodash
- ngxPermission
- ngxFavIcon
- ngxPagination
- ngxColorPicket
- ngxMask
Les Packages utilisés sur le côté Laravel
- barryvdh/laravel-dompdf
- thiagoalessio/tesseract_ocr
- chumper/fermeture à glissière
- kwn/nombre-de-mots
- maatwebsite/excel
- ajcastro/hâte-charge-pivot-relations
- milon/code à barres
- tymon/jwt-auth
Vidéo De Présentation
Version 3.0
OCR MBH – Version 3.0 Release Notes
Release Date: February 2026
Version: 3.0
🚀 Overview
OCR MBH v3.0 delivers major improvements in performance, scalability, and accuracy. This release introduces advanced queue management, supplier-driven extraction logic, batch processing, cluster execution, and infrastructure optimizations to support high-volume accounting document processing.
✨ New Features
ZED – Execution Queue System
Introduced ZED, a dedicated queue for storing and managing workbooks awaiting OCR execution.
Ensures controlled processing and improved execution stability.
Supplier Profile Management
Added a new interface to define and manage supplier profiles.
Centralizes supplier configuration and OCR-related metadata.
Advanced Pattern & Account Mapping
Introduced an advanced interface to define extraction patterns per supplier.
Enabled mapping of extracted fields to accounting accounts.
Added pattern testing on line items with preview of extraction results.
Supplier Filtering Enhancements
Added new filters in the supplier list:
Suppliers with defined patterns
Suppliers without patterns
Improves configuration tracking and setup efficiency.
Enhanced OCR Execution Engine
Added advanced field mapping during OCR execution.
Introduced flexible data cleanup options, including deletion rules.
Improved execution stability and data consistency.
Batch (Lot) Processing
Added batch processing to execute or modify multiple workbooks simultaneously.
Enables faster operations and bulk updates.
Image Comparison
Added image comparison functionality to visually verify OCR results against original documents.
Cluster Execution
Introduced cluster-based OCR execution to support large-scale processing.
Improves performance and throughput for high document volumes.
VPS & Infrastructure Improvements
Increased RAM capacity to support larger workloads.
Improved CPU utilization for better processing performance.
Enhanced overall system stability for continuous OCR execution.
🛠 Improvements & Optimizations
Improved system performance under heavy workload.
Optimized OCR execution pipeline for scalability.
Enhanced reliability for large workbook processing.
✅ Summary
OCR MBH v3.0 is a major upgrade focused on automation, scalability, and performance. With advanced supplier configuration, batch execution, and infrastructure enhancements, this version significantly improves operational efficiency and processing capacity.
Version 1.0
Clone pour le GIT
https://gitlab.com/bensassi/nutriprocess.git
 French
 English